NVLink 到底有多快:把带宽、并行策略和 token 产出算清楚
大模型推理基础设施实战系列 · 第 12 篇
一台八卡 H20,NVLink 规格写着 900 GB/s,单向拷贝却测出约 394 GB/s。若直接拿两者相除,很容易把“单向与双向的口径差异”误判成性能损失。进一步部署模型时,还会遇到更实际的问题:扩大 TP 能否缩短生成时间,增加副本又能多产出多少 token。
这篇文章沿着一组真实 H20 截图,把硬件带宽、通信开销与推理产出连起来。读完后,你应当能读懂带宽矩阵、筛选并行配置,并判断一次通信优化是否值得继续投入。
先抓住三个重点:
- 比较带宽,先统一路径和方向。 本地显存、卡间互联和机间网络各管一段;900 GB/s 的双向规格要拆成对应的单向口径。
- 选择并行,看省下的计算能否覆盖新增开销。 卡数增加后,通信、同步和流水线等待也可能增加。
- 评价收益,落到请求体验与实际输出。 TTFT 看多久开始回答,TPOT 看持续生成速度,输出 TPM 看整组服务的产出。
1. 先分清显存、卡间与机间带宽
推理中的数据搬运主要经过三条路径:读取本卡权重和 KV、与其他 GPU 交换数据,以及跨节点传输。每条路径都有自己的带宽和延迟。

图 1|本地显存、GPU 互联与节点网络。访问远端显存时,端点显存与互联共同参与数据搬运。
| 带宽层级 | 主要数据路径 | 对推理的影响 |
|---|---|---|
| GPU 本地显存 | SM 经缓存访问本卡 HBM 或 GDDR | 权重、KV 与中间结果的读取和写回 |
| GPU 互联 | GPU 经 NVLink、NVSwitch 或 PCIe 交换数据 | TP 集合通信、EP token 分发、PP 激活传输 |
| 节点网络 | GPU/主机经 NIC 与远端节点通信 | 跨机 TP、PP、EP,以及分离部署中的数据传输 |
P2P 指 GPU 之间的对等访问,NVLink 和 PCIe 都可能承载这类访问;直接 P2P 不可用时,数据还可能经主机内存中转。判断性能时,需要结合实际路径查看端点显存、互联和网络的利用情况。
1.1 900 GB/s 是怎样算出来的
NVIDIA 的 NVLink 规格表列出:第四代 NVLink 每 GPU 带宽为 900 GB/s,最多 18 条链路。Hopper 架构说明给出的单链路每方向带宽为 25 GB/s,满配时可换算为:
单方向:18 × 25 = 450 GB/s
双方向合计:18 × 25 × 2 = 900 GB/s
因此,900 GB/s 是单卡所有链路的双向合计规格;多个目的端共享这张卡的发送能力。与单向拷贝结果比较时,应使用 450 GB/s 的对应口径。
1.2 跨机带宽还要看网络路径
项目 H20 部署记录中的“8 rail × 400 Gb/s”,按端口标称速率相加为 8 × 400 ÷ 8 = 400 GB/s。一条传输能利用多少 rail,则取决于 GPU–NIC 亲和性、PCIe 路径、网络配置和通信库。H20 部署与拓扑(系列第 11 篇)
机内 TP 主要使用 GPU 互联,跨机 TP、PP 或 EP 还要经过节点网络。因此,选并行方式时既要看卡数,也要看通信跨越了哪些硬件路径。
2. H20 实测:读懂峰值、分布与 P2P 差异
2.1 CE 单向拷贝:约 368–394 GB/s
现场使用 nvbandwidth v0.10.0,CUDA Runtime/Driver API 为 13.2,驱动为 595.58.03,运行 CE 单向读取用例:
./nvbandwidth -t device_to_device_memcpy_read_ce
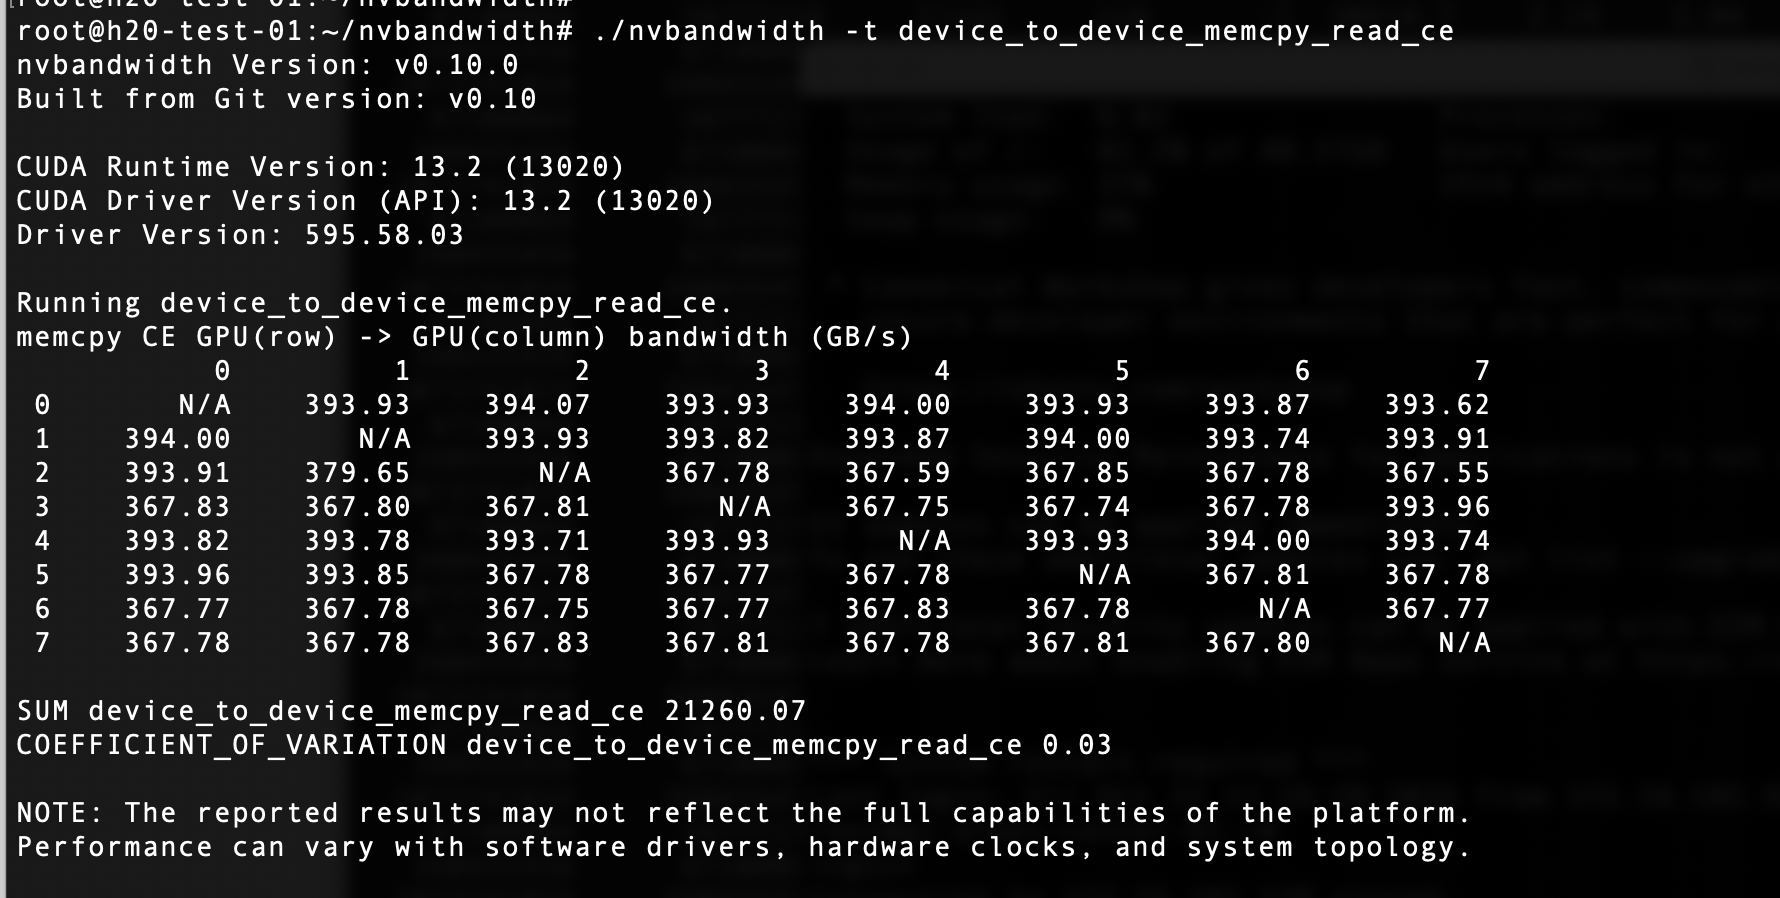
截图 1|CE 单向读取。56 个跨 GPU 测量值分布在 367.55–394.07 GB/s,主要集中于约 368 和 394 GB/s 两组。
读这张图,要看完整分布。 约 368 与 394 GB/s 两组结果同时存在,只取最高格会掩盖 GPU 对之间的差异。该用例逐对测量,SUM 21260.07 是各对结果相加,并非八卡同时通信的整机带宽。nvbandwidth v0.10 测量说明
2.2 P2P 开关:单向带宽的明显差异
连通矩阵全为 1,说明这些 GPU 对支持对等访问。在下面这组测试中,P2P Disabled 的跨卡单向带宽为 31.30–37.00 GB/s;启用 P2P 后,单向写入达到 321.74–393.79 GB/s。
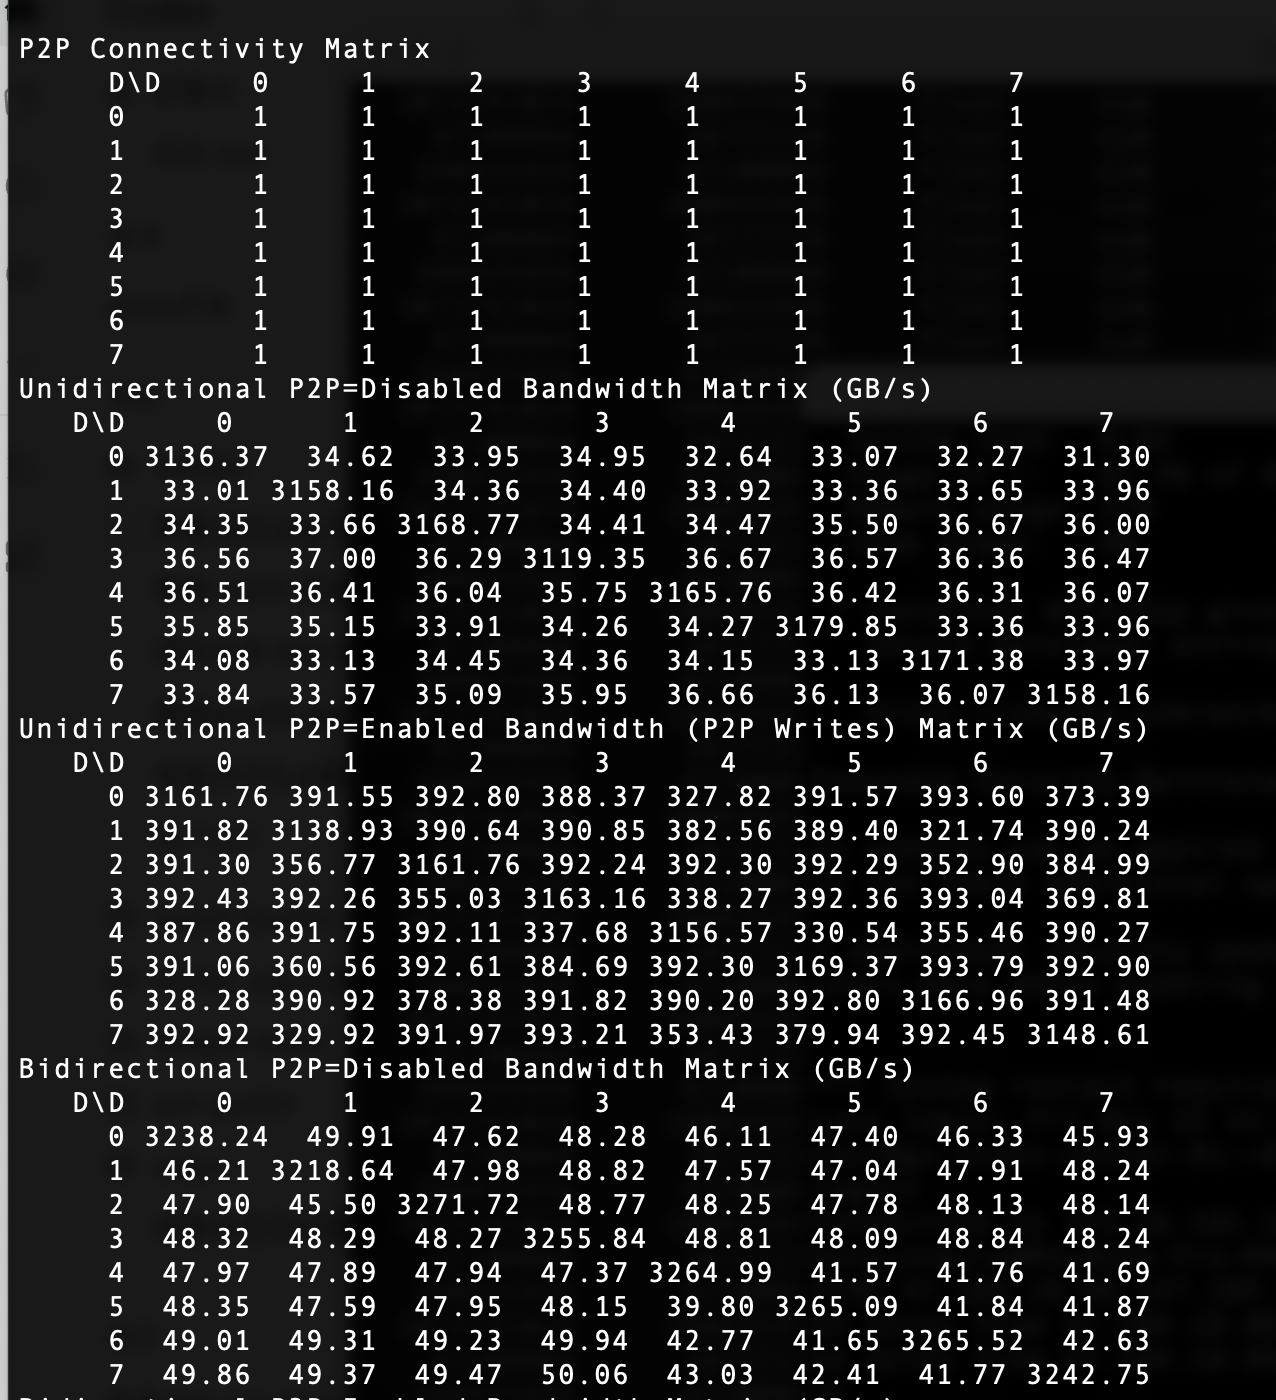
截图 2|P2P 连通性与单向带宽。对角线上约 3,100 GB/s 的值属于本卡拷贝,跨卡统计只取非对角元素。
这里最值得关注的是实际使用的传输路径:同一组 GPU,P2P 开关对应的拷贝结果就有明显差异。排查低带宽时,先检查对等访问是否可用、程序是否使用了预期路径,再分析链路和时钟。
2.3 双向带宽:多数约 765 GB/s,仍有低值
双向矩阵的中位数为 765.08 GB/s,最高为 768.31 GB/s。56 个非对角元素中,40 个位于 750–780 GB/s,同时保留了 373.61、389.25、413.98 GB/s 等较低值。
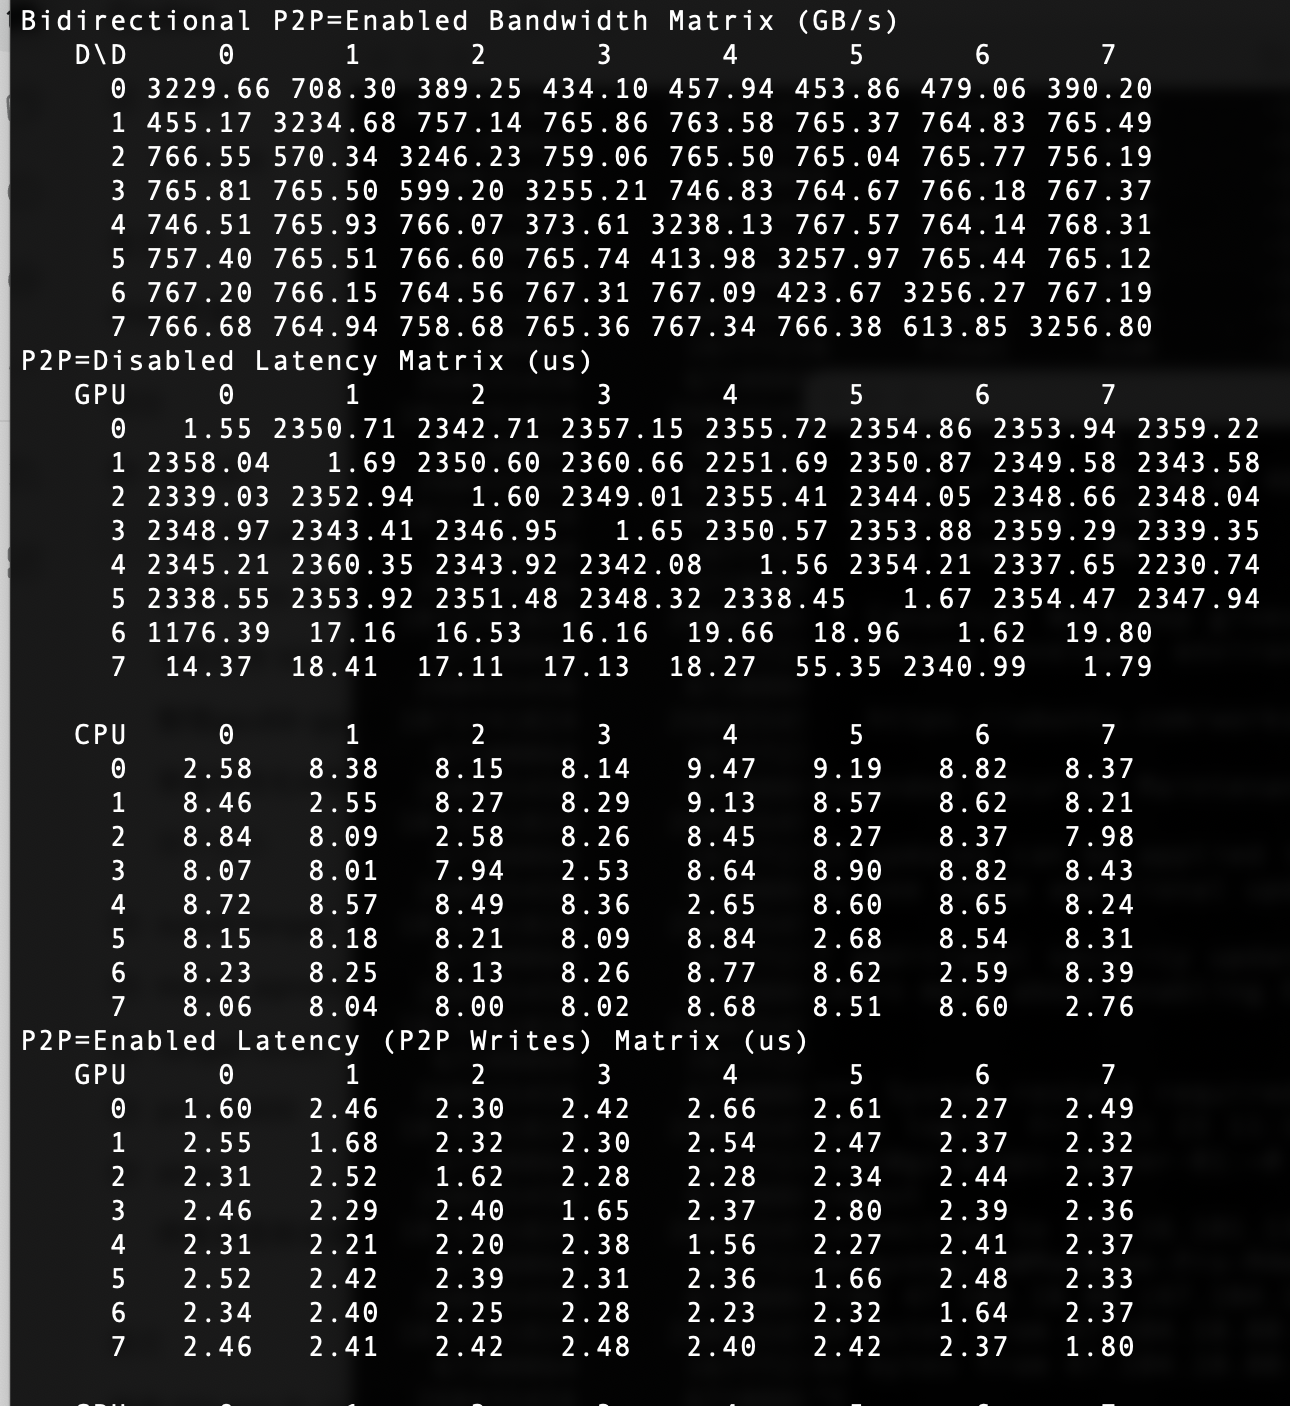
截图 3|P2P 双向带宽与延迟。最下方 P2P Enabled 表的 GPU 计时延迟为 2.20–2.80 μs。
后两张图的输出格式对应 NVIDIA p2pBandwidthLatencyTest。该样例按“两个方向的数据量之和 ÷ 共同耗时”计算双向带宽,因此图中的 768.31 GB/s 已包含两个方向。CUDA Samples 计算方式
三张截图的跨 GPU 结果汇总如下。每行统计一张矩阵的 56 个非对角元素,中位数反映 GPU 对之间的分布。
| 测试项 | 范围 | 中位数 | 单位 |
|---|---|---|---|
| nvbandwidth CE 单向读取 | 367.55–394.07 | 367.83 | GB/s |
| P2P Disabled 单向 | 31.30–37.00 | 34.43 | GB/s |
| P2P Enabled 单向写入 | 321.74–393.79 | 390.89 | GB/s |
| P2P Enabled 双向 | 373.61–768.31 | 765.08 | GB/s |
| P2P Enabled GPU 计时延迟 | 2.20–2.80 | 2.37 | μs |
这组结果给出了两个后续方向:低值 GPU 对需要在固定消息大小、负载和时钟下复核;模型采用的集合通信则需要按真实 rank 数继续测量。拷贝矩阵告诉我们数据怎样搬得动,集合通信测试才更接近 TP/EP 的实际工作。
3. 并行策略:计算省了多少,通信增加多少
能放下模型,是容量问题;能否更快输出,是执行效率问题。 先为权重、运行开销和目标 KV 留足显存,再比较候选配置的计算、通信与等待时间。NVLink 的价值,在于降低其中的卡间通信代价。

图 2|TP 切层内计算,PP 切网络层,普通推理 DP 将不同请求分给完整副本。
| 方式 | 切分对象 | 主要代价 |
|---|---|---|
| TP:张量并行 | 层内权重与计算 | 频繁集合通信,以及切分后内核效率的变化 |
| PP:流水线并行 | 不同网络层或阶段 | 激活传输、阶段负载不均与流水线空泡 |
| DP:数据并行 | 不同请求或数据批次 | 完整副本的显存需求、路由与缓存局部性 |
| CP:上下文并行 | 上下文/注意力相关计算与状态 | KV 分布及注意力通信 |
| EP:专家并行 | MoE 专家 | token 分发/合并、专家负载与跨域通信 |
SP(序列并行)与 CP 都涉及序列维度,但切分的计算和状态可能不同,使用时要核对模型与框架实现。Megatron Core 对 CP 与 SP 的区分
3.1 TP、PP 与 DP/EP 怎样取舍
TP 用通信换取层内计算的分摊。 扩大 TP 时,重点比较计算缩短的时间与新增通信、同步开销;同时检查分片后的矩阵形状是否仍适合当前 kernel。vLLM 同时支持双机 TP8×PP2 和跨机 TP16;两者的取舍取决于容量约束、网络开销和计算收益。vLLM 并行与扩展
PP 用阶段切分分摊模型容量。 单请求仍需依次通过各阶段,单流延迟要看各阶段执行与传输的耗时;多请求吞吐还受最慢阶段与流水线空泡影响。微批能否提高利用率,要结合阶段均衡和实际在飞请求数判断。
DP 用副本承接不同请求,MoE 还要看 EP 范围。 普通推理副本不需要训练中的梯度同步;MoE 的多个 DP 组可能共同参与一个 EP 组,仍需交换专家 token。核算卡数时,应按实际进程组关系计算。
3.2 双机 H20 的两个项目实例
| 项目阶段 | 已采用的形态 | 通信特点 |
|---|---|---|
| Kimi-K3 的 H20 验收 | TP8×PP2 | 机内做 TP,跨机传递流水线激活;另有权重卸载约束 |
| DeepSeek-V4.1-Flash 的 H20 部署 | TP8×DP2+EP16 | 注意力分两组,专家跨 16 卡通信 |
Kimi 这一路径主要跨机传递阶段激活;DeepSeek 的专家通信跨越两台机器,因此两个注意力 DP 组仍有通信关联。比较并行配置时,先画出模型的数据流,再数 TP、PP、DP 和 EP。 具体配置见 Kimi H20 部署实战(系列第 4 篇)与 DeepSeek H20 部署实战(系列第 11 篇)。
4. 按四个层次验证通信与推理性能
确定候选配置后,按“拓扑 → GPU 拷贝 → 集合通信 → 实际推理”逐层检查,可以逐步缩小问题范围。

图 3|从硬件路径到业务表现逐层检查,并与同型号、同拓扑、同条件的基线比较。
4.1 拓扑:核对 GPU、CPU 与 NIC 的连接
用 nvidia-smi topo -m 查看 GPU、CPU 与 NIC 的相对关系;支持 NVLink 的平台结合 nvidia-smi nvlink -s、错误计数和系统日志检查链路。
下面的现场拓扑有两个读图重点:GPU 之间均显示 NV18;GPU 到 NIC 的距离却不同,例如 GPU0–NIC0 为 PIX,GPU0–NIC4 为 SYS。前者经过至多一个 PCIe bridge,后者还要跨 NUMA 互联。
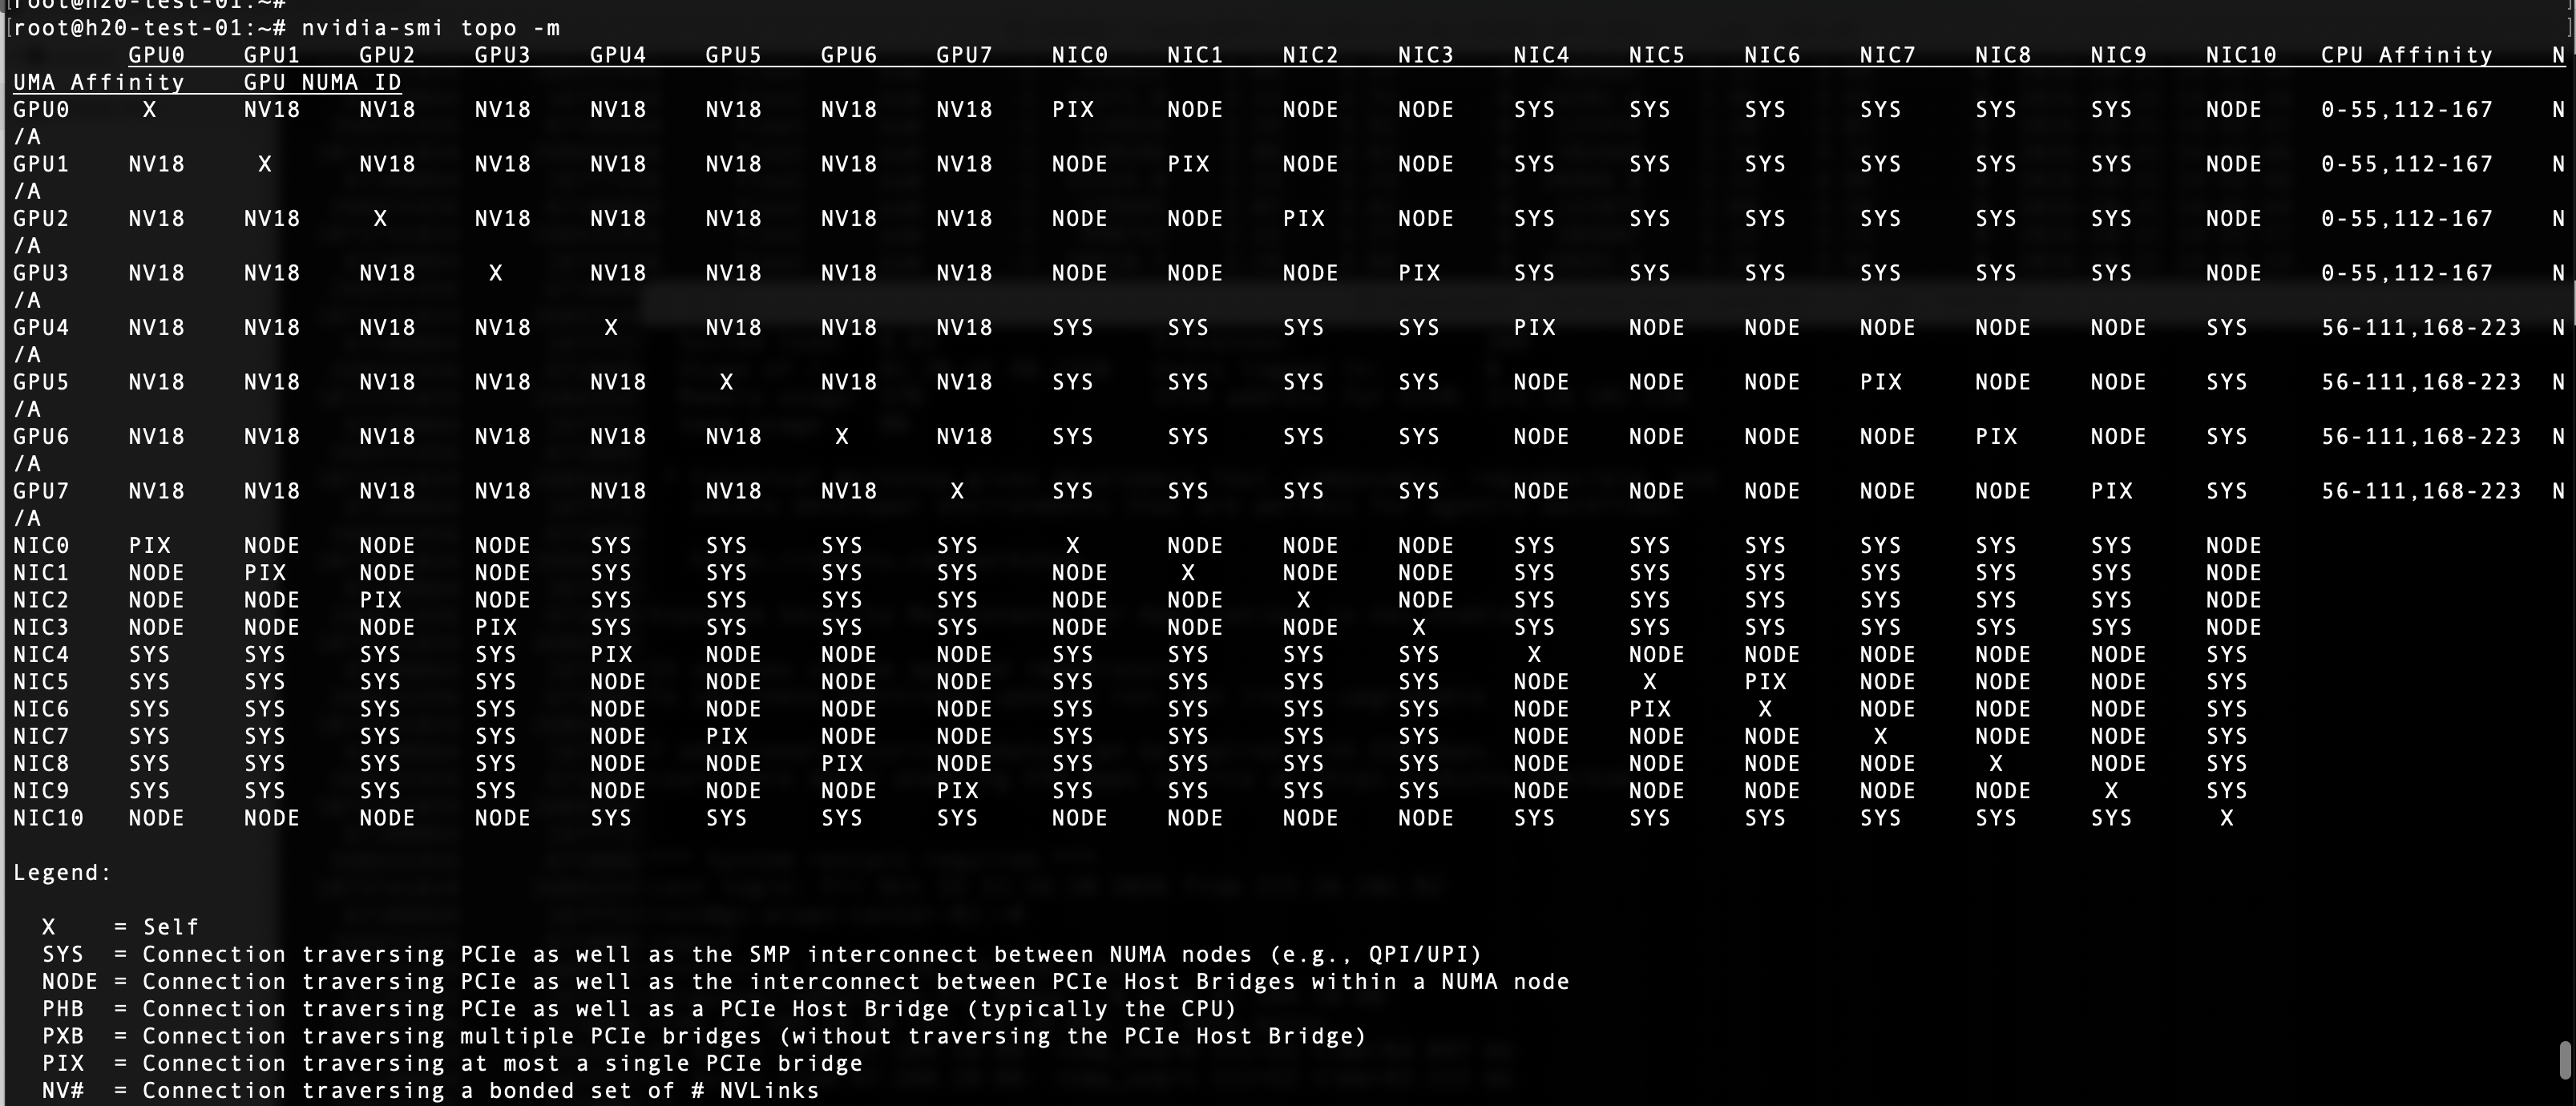
截图 4|机内 GPU 互联与 GPU–NIC 亲和性。GPU 间互联相同,访问不同 NIC 的路径仍可能不同。
因此,机内拷贝测得快,跨机通信仍可能受 GPU–NIC 选择影响。具体使用了哪张 NIC、哪条传输路径,再结合 NCCL 日志或 trace 核对。
4.2 GPU 拷贝:分别检查 CE 与 SM 路径
nvbandwidth 的 CE 用例通过 memcpy API 使用拷贝引擎,SM 用例通过 kernel 搬运数据。两者的发起方式和资源占用不同,可以互相补充。NVIDIA nvbandwidth
测试记录应包含 GPU 对、读/写方向、单向/双向、buffer 大小、重复次数和软件版本。跨工具比较前还要核对计数方式:例如,nvbandwidth 的 CE 双向用例在反向流量并发时统计被测方向,与前文 P2P 样例的双向合计口径不同。
第 2 节的 CE 矩阵可以作为拷贝路径的起点。接下来应保持 GPU 对和消息大小一致,再比较 SM 用例与实际集合通信,观察差异出现在哪一层。
4.3 集合通信:读懂 algbw 与 busbw
用 nccl-tests 测量部署实际需要的集合操作,并覆盖有代表性的 rank 数和消息尺寸。大消息更容易暴露带宽限制,小消息更容易受启动、同步和延迟影响。
对 AllReduce,设输入消息大小为 S 字节、耗时为 t 秒、rank 数为 n:
algbw = S / t
busbw = algbw × 2(n − 1) / n

n = 8:busbw = algbw × 1.75
n = 2:busbw = algbw
两者的单位都是字节/秒,换成 GB/s 均需除以 10^9。algbw 按输入消息量计算,busbw 按集合操作的通信模型归一化,用于比较通信效率。nccl-tests 指标说明

图 4|算术示例:同一次八 rank AllReduce,algbw 为 200 GB/s 时,busbw 为 350 GB/s。
比较业务耗时,先看同一消息量的时间或 algbw;比较归一化通信效率,再看 busbw。 后者需要结合算法、拓扑和消息尺寸解释。两 rank 的换算系数虽为 1,归约计算、同步与 kernel 启动开销依然存在。
4.4 实际推理:把通信耗时放回请求时间线
最后用真实模型观察 TTFT、TPOT、总 TPM、输出 TPM,以及失败、排队和缓存复用。若通信测试正常而请求仍慢,就沿时间线继续检查算子、batch、KV、卸载和调度,定位实际耗时所在。
5. 带宽怎样影响 token:关键在单步耗时
小 batch 的自回归 decode 经常受到权重访存限制。随着 batch 和上下文增长,计算、注意力、TP/EP 通信及调度的占比也会变化。判断瓶颈需要同时看数据量、算子形状和执行时间线。GPU 性能背景指南

图 5|decode 的主要数据依赖。计算与通信是否重叠,决定了各项耗时怎样进入单步关键路径。
5.1 用数据量估算理想访存时间
设 D_mem 为某张卡在本轮实际从显存搬运的字节量,按规格带宽估算的理想访存时间为:
t_mem,ideal(s) = D_mem(bytes) / BW_peak(bytes/s)
例如,假设每卡本步读取 4.625 GB,规格带宽为 4,000 GB/s,理想访存时间约为 4.625 ÷ 4000 × 1000 = 1.156 ms。这个算术示例只计算访存一项,完整 TPOT 还包含计算、通信与调度等开销。
估算的关键是确定 D_mem。MoE 的实际权重读取量取决于整个 batch 涉及的专家并集;KV 访问量取决于注意力类型、上下文长度和实现。TP 可以切分注意力头及相关 KV,在 KV 头数少于 TP 数等情况下也可能发生复制。vLLM 注意力头分片与复制
量化能减少权重存储和读取量,最终收益则取决于量化 kernel、转换开销,以及访存在总耗时中的占比。
5.2 通信快一倍,单步能缩短多少
下面只做算术演示:假设单请求每步生成一个 token,单步共 20 ms,其中通信 4 ms、其余工作 16 ms;两部分串行。再假设通信完全受带宽限制,有效带宽翻倍后,这 4 ms 才能减半。
| 算术示例 | 原假设 | 通信加速后 |
|---|---|---|
| 通信时间 | 4 ms | 2 ms |
| 其余工作 | 16 ms | 16 ms |
| 单步总时间 | 20 ms | 18 ms |
| 单请求输出速率 | 50 token/s | 约 55.6 token/s |
单步时间缩短 10%,输出速率提高约 11.1%。通信优化的收益,取决于它原先占用了多少关键路径时间。 若通信与计算重叠,还要找出没有被计算覆盖的那部分等待;若小消息主要受启动和同步影响,带宽翻倍也未必让通信时间减半。
这个例子也给出了调优顺序:先从 trace 找耗时占比,再选择优化对象。只有把通信耗时放回完整请求,才能估计更快的互联会带来多少实际收益。
5.3 TTFT 看首 token,TPOT 看后续生成
普通自回归生成通常在 prefill 末端得到首个输出 token。按 vLLM benchmark 的请求级定义,输出多于一个 token 时:
TPOT = (端到端延迟 − TTFT) / (实际输出 token 数 − 1)
首 token 前的排队与 prefill 计入 TTFT;后续生成期间插入的 prefill、抢占和调度停顿,仍可能影响 TPOT。请求级 TPOT 与逐 token 间隔 ITL 的分位数也需要分别统计。vLLM Benchmark CLI
比较不同硬件时,应控制模型、引擎、量化、并行配置、实际上下文、输出长度、并发和缓存状态。TPOT 与显存带宽的比例关系可以提供分析线索,具体瓶颈再由 profiling 或单变量对照验证。
5.4 用同一时间窗口计算 tps 与 TPM
输出 tps = 同窗实际输出 token 总数 / 墙钟秒数
总 tps   = 同窗实际输入与输出 token 总数 / 墙钟秒数
输出 TPM = 输出 tps × 60
总 TPM   = 总 tps × 60
输出 TPM 表示实际生成能力;总 TPM 同时计入输入 token,其中还可能包含前缀缓存复用的部分。报告应同时列出两者,并注明并发 C、请求数 N、实际输入/输出和缓存状态。压测方法与指标(系列第 5 篇)
活跃 batch ÷ 单步耗时 可用于 batch 稳定、每请求每步生成一个 token 的简化估算。连续批处理、流水线和推测解码场景,应直接采用同窗实际输出计数与墙钟时间。
6. 把测量结果变成部署选择
先确认容量与输出正确性,再按业务目标选择指标:
| 业务目标 | 重点观察 | 对照方向 |
|---|---|---|
| 交互响应 | TTFT、TPOT 及尾部延迟 | TP 通信开销、单请求执行时间与排队 |
| 批量生成 | 延迟约束内的输出 TPM | batch、并发、DP 副本和负载均衡 |
| 长上下文 | KV 容量、冷/暖 TTFT、混合请求等待 | KV 分布、前缀缓存、prefill 调度与 PP 阶段负载 |
实际推进时,可以按下面的顺序缩小候选范围:
- 先过容量门。 若权重与目标 KV 放不下,先选能容纳它们的 TP/PP/EP 组合,并核对卸载代价。
- 再定位时间花在哪里。 拷贝慢就查路径与 GPU 对;集合通信慢就查 rank、消息尺寸和算法;通信正常但生成慢,就看算子、访存与调度。
- 只改变一个关键变量。 扩大 TP 时对照计算与通信;调整 PP 时检查阶段均衡;增加 DP 时对照排队、缓存和输出 TPM。
- 用业务指标作决定。 同一模型、输入/输出、并发和缓存条件下,确认正确性与尾部延迟,再比较输出产出。
选择配置时,最终需要回答的是:每个 token 在哪里等待,改动能减少多少等待,以及这份收益需要多少 GPU 资源。 这三个问题比单独追求一张带宽表里的最高值,更能指导下一步部署。
系列目录
- KV Cache 与前缀缓存:从原理到 99.9% 命中率的生产实践
- PD 分离实战:Prefill/Decode 拆池、配比拐点与容量规划
- GPU→内存→SSD 三级 KV 缓存:Mooncake 分层实战与跨引擎复用陷阱
- Kimi-K3 原始 MXFP4 权重512K 长上下文生产部署:双机 16 卡 TP8×PP2 与 CUDA Graph 调优
- 大模型压测方法论:如何让性能数据可信
- 推理集群可观测性:64 卡监控体系与缓存证据链
- MiniMax-H3视频生成服务化:ComfyUI 多 GPU 编排与长任务生命周期
- 掉卡排查实录:RTX 5070 反复 Xid 79,如何排查建立证据链
- GPU对调定位法:8 卡 RTX 6000D 掉卡,如何用对调缩小故障范围
- CUDA 802 不是 NCCL 网络故障:H20 NVSwitch 物理链路排查实录
- DeepSeek-V4.1-Flash 双机 16 卡 H20 部署压测:TP8×DP2 与跨机 EP 的边界
- NVLink 到底有多快:把带宽、并行策略和 token 产出算清楚(本篇)