DeepSeek-V4.1-Flash 双机 16 卡 H20 部署压测:TP8×DP2 与跨机 EP 的边界
大模型推理基础设施实战系列 · 第 11 篇
1. 背景与目标
目标是在两台各 8×H20 上运行 DeepSeek-V4.1-Flash,提供 256K 上下文,供内部团队进行长文档问答与代码理解。本批配置记录为 40 层、384 专家、top-6、DSA 稀疏注意力与 Engram。
1017 版本有 48 个权重分片,完整目录约 510.31 GB,约 475.26 GiB。权重文件体积、每 rank 日志中的模型分配量和 GPU 总显存占用是三种数,不能互相替代。
H20 属于 Hopper,不能直接套用 Blackwell 原生 FP4 内核;本环境的 fp4-indexer 路径曾因不支持而拒绝。最终使用 vLLM 的已验证后端。硬件支持差异本身不能证明整段 prefill 必然受算力限制,也不能断言 decode 不受影响。
2. 部署环境与并行方案
2.1 先看物理拓扑,再看并行组
| 项目 | 本次配置与边界 |
|---|---|
| GPU | 2 台 ×8×H20;单卡可见显存 97,871 MiB,约 95.577 GiB |
| 机内互联 | NVLink/NVSwitch,盘点为全卡互见 NV18 |
| 机间互联 | 每机 8 个 400Gb/s Ethernet/RoCE 端口;不是单请求实测聚合带宽 |
| 注意力并行 | 两个 DP 调度组,每组 TP8 留在本节点 |
| 专家并行 | EP16 跨两节点分片,384÷16=24 专家/卡 |
| 引擎 | 官方 vllm/vllm-openai:v0.31.0,Marlin,KV FP8,前缀缓存 |
| 窗口与调度 | 262,144 token;每引擎 max-num-seqs 32,合计最多 64 个调度槽 |
| 投机解码 | dspark,num_speculative_tokens=3 |
| KV 池 | 日志为 16,593,113 token/DP 组;理论容量比约 63.3 个 256K 窗口,不是并发验收成绩 |
TP8×DP2+EP16 不是两个可独立生存的完整模型副本。 注意力层在各自 TP8 组内运行,专家层却需要跨整个 EP16 组分发与汇集 token。一侧故障可能影响两组请求;没有实测单侧故障隔离,不能写“两副本故障隔离”。
vLLM 官方 EP 说明将专家组定义为 TP×DP,注意力权重则在各 DP 组内按 TP 分片。这也意味着每次请求可能多次参与跨机专家通信,不能描述成“全程留在单节点,只有无足轻重的小包”。
2.2 为什么采用这个布局
本次按既定需求采用 DP2+EP16,没有做同条件 PP2 对照。该布局提供两个调度组及两份注意力 KV 池;PP2、独立单机副本、不同 TP/EP 规模的优劣,仍需在同卡数、同负载、同延迟目标下比较。
模型能装进单节点,只说明跨机切层不是装载的必要条件,不代表 PP 永远没有价值。TP 也没有“最多只能等于单机卡数”的硬规则;跨机 TP 可行,只是更依赖网络与通信开销。
日志中的约 21.13 GiB/卡是本次加载分配记录,不能拿它与“510 GB÷8”的文件体积商相减,声称 EP 单独释放了约 40 GB/卡。未做 EP 开/关容量对照,也不能说不启用 EP 就每卡存全量专家:TP 同样可以切分专家矩阵。
2.3 九次启动:五次失败,四次就绪
| 次数 | 结果 | 已记录原因或变更 |
|---|---|---|
| 1 | 失败 | 缺 data-parallel-size-local,local rank 越界 |
| 2 | 失败 | head 的 start-rank 触发不匹配的负载均衡模式 |
| 3 | 失败 | 大权重首载未在就绪超时内完成 |
| 4 | READY,390s | 调大就绪超时 |
| 5 | READY | max-num-seqs 16→32 |
| 6、7 | 失败 | entrypoint 与参数重复或不匹配 |
| 8 | READY,270s | dspark 配置定版 |
| 9 | READY,450s | 换型 1017 |
加载受页缓存、文件系统、编译和初始化共同影响。390、270、450 秒这些记录不支持“复载快一个量级”;跨阶段耗时也不是严格冷盘/热盘 A/B。
3. 压测方法与实测结果
3.1 输入档位与实际输出
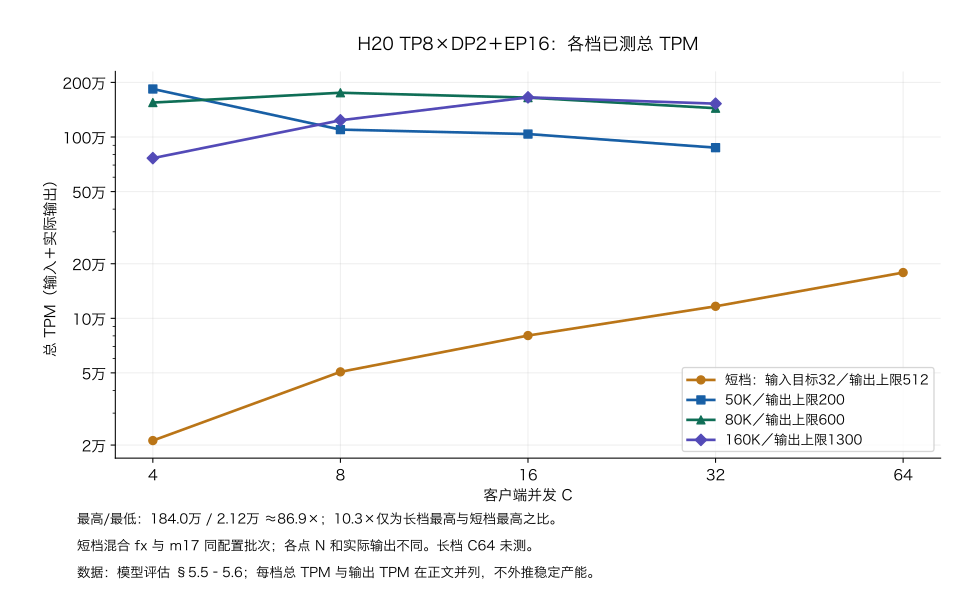
本文主矩阵使用 1017、TP8×DP2+EP16+dspark、8192 分块、每引擎 32 槽。输入目标为 32、50K、80K、160K;512、200、600、1300 是输出上限,不是固定实际输出长度。
例如 50K/C4N8 的实际输入共 399,640 token、输出共 607 token;80K/C8N16 输出共 1,195;160K/C16N16 输出共 1,248。自然结束的短答不能代表持续生成满输出预算。
fx 批次有 16 组记录、322 次 API 请求,失败、unknown、重试均为 0;短档 C8/C32/C64 来自较早的 m17 批次,同配置但非同一连续扫描。两批合并展示时保留来源差异,不把记录条数当作请求总数。
冷前缀、冷进程、冷编译和冷文件缓存分别记账。另一个 6000D 实验采用“预热、flush、换 seed”,不能搬过来当成本批 H20 已执行的步骤,也不是线上服务必须 flush 的通用规则。
3.2 吞吐口径
总 TPM=60×实际输入与输出 token 之和÷共同墙钟;输出 TPM=60×实际输出 token÷同一墙钟。单流生成阶段速度使用不同的时间区间,不能替代端到端输出 TPM。
总 TPM 的已列最小/最大值为 21,170 与 1,840,234,约 86.9 倍。输出 TPM 为 419–165,230,约 394 倍。这些范围混合不同输入长度和并发,只说明指标对负载构成敏感,不代表同一任务的加速倍数。
3.3 各档最高观察值
| 档位(输入目标/输出上限) | C / N | 总 TPM | 输出 TPM | TTFT p50(s) |
|---|---|---|---|---|
| 32 / 512 | 64 / 64 | 178,817 | 165,230 | 0.54 |
| 50K / 200 | 4 / 8 | 1,840,234 | 2,791 | 8.47 |
| 80K / 600 | 8 / 16 | 1,754,065 | 1,638 | 22.18 |
| 160K / 1300 | 16 / 16 | 1,654,473 | 808 | 37.64 |
短档总 TPM 随所测 C4→C64 增长,首个增幅约 139%,其余约 45%–59%。C64 未测更高并发,不能据此保证继续扩展。
长档分别在 C4、C8、C16 取得最高观察值,到 C32 回落约 52.5%、17.8%、7.7%。这些结果支持为不同负载分别设定准入,而非“长文档加并发必然有害”。分块预算、排队、输出长度和 N 同时影响结果,尚未单独证明回落由某一个参数造成。
3.4 冷暖对照与容量边界
fx 的 75,654-token 单请求对照,冷/暖 TTFT 为 11.019/0.336 秒,约 32.8 倍;输出分别 77/78 token。总 TPM 为 397,849/6,615,887,输出 TPM 记 N/A:本次本地复核仅有已取整摘要,缺少该对照的完整逐请求墙钟原件,未用 token 比例估算顶替。
响应当时没有 cached_tokens。缓存计费须区分输入未命中、输入命中和输出,分别乘对应单价;TTFT 还包含调度及固定开销,不能反推出可用于计费的命中 token。本组命中 token 与缓存费用记 N/A,后续补齐上报字段不回填旧请求。
16,593,113÷262,144≈63.3 是每组理论 KV 容量比。两组约 126 个完整窗口的粗略存量不能写成“126 条满窗同时服务”:每组只有 32 个调度槽,还受块对齐、输出增长、专家通信与排队影响。20 人日常无排队没有专项验收依据。
持续生成样例的单流速度为 133.39 token/s;C64 短档聚合输出约 2,753.8 token/s、单流中位约 51。它们是不同负载下的不同统计量,不能拼成“64 人各自持续 133 token/s”。
3.5 硬件窗口不等于瓶颈证明
本批使用 nvidia-smi dmon 约 1 秒采样。汇总中的 sm 列约 90.7% 是 GPU 活跃时间类指标,不是 SM active、Tensor 利用率或 MFU;mem 列约 5.4% 也不能直接换成显存带宽利用率。
16 卡同窗均值功耗合计约 3,814 W、同刻峰值合计约 4,755 W。节点汇总不能替代逐卡原件;显存原表约 92,153/93,702 的数值单位还须按实际 dmon 表头确认,暂不作 GB/GiB 换算。
要进一步确定瓶颈,需要算子时间线、等待比例及针对性对照,不能仅凭 busy 高、功耗或 mem 低来判断。
4. 两个权重版本的对照
旧版与 1017 使用相同引擎配置和并行布局,结构配置记录一致。以下是局部对照,输出自由生成且部分长度不同;每格重复性有限,不是持续产能或完整质量等价验收。
| 项目 | 旧版 | 1017 | 观察 |
|---|---|---|---|
| 名为 cold-50k 的探针(实际约 75,654 输入)TTFT | 11.51s | 9.65s | 约 −16.2% |
| 持续生成样例 decode-2k | 142.97 tok/s | 133.39 tok/s | 约 −6.7% |
| C64 短档总 TPM | 150,936 | 178,817 | 约 +18.5% |
| C64 短档输出 TPM | 约 139,746 | 165,230 | 约 +18.2%;旧值由已取整输出 tps×60 |
| C64 单流生成中位 | 52.07 tok/s | 51.03 tok/s | 约 −2.0% |
| C64 TTFT p50 / max | 0.49 / 9.83s | 0.54 / 0.93s | 本批最大值下降,不承诺尾延迟消失 |
本轮选择 1017,同时保留持续单流速度下降。输出更短本身不等于质量更好或完成同一业务更省钱;质量与业务成本需要另行验收。
5. 参数与内核优化:分清不同实验
5.1 H20 的槽位与投机解码
旧版 ms16→ms32 对照中,C64 短档聚合输出由 1,612.9 增至 2,577.0 token/s,约 +59.8%;C32 的 8K 档由 195.7 降至 144.6,约 −26.1%。
ms32 的 dspark 对照中,持续单流由 66.11 增至 142.97 token/s,约 2.16 倍;C64 聚合输出由 2,577.0 降至 2,329.1,约 −9.6%;KV 池由约 18.61M 降至 16.59M。应按单流体验、总体完成率和容量共同选型,不能只保留收益。
这些摘录没有完整同窗 token 分子,故不补造总/输出 TPM 表;完整原始口径见来源报告的槽位和 dspark 分组。不同阶段的 2,577、2,329、2,754 不应拼成同一次三档测试。
5.2 6000D 的历史内核派发问题
这是另一批 SGLang/FlashInfer 0.6.18 实验,与前文官方 vLLM H20 部署分开。归档报告将 SM120 稀疏注意力路径的模板支持缺口、旧 AOT 产物与 Triton 回退联系起来;补丁加入模板实例,重新构建并保存可复现制品。
归档摘要报告 P 阶段约 3.4 倍改善。该数绑定特定补丁、形状和基线,不能推广为所有 FlashInfer/6000D 部署的收益。“只加模板、不改公式”也不能替代数值与模型正确性测试。
同档对照的下表单位是输入 token/s。C4、MR4、ctx 1M、chunk4096、KV FP8、同 seed,均为单机 8 卡;每格并非多轮统计。
| 输入/输出目标 | 6000D 单机 | H20 单机 | 比值 | 总/输出 TPM |
|---|---|---|---|---|
| 50K/200 | 6,660 | 3,761 | 1.77× | N/A¹ |
| 80K/600 | 5,962 | 3,076 | 1.94× | N/A¹ |
| 160K/1300 | 5,611 | 2,432 | 2.31× | N/A¹ |
| 380K/7000 | 3,872 | 1,395 | 2.78× | N/A¹ |
¹ 归档报告的部分 TPM 按目标入/出比例换算,本文未从该组逐请求实际 token 与墙钟独立复算,因此不将估算当实测。输入速度比值描述这组软硬件组合,不是裸硬件算力比。
另一组 22.0–25.8ms TPOT 来自 6000D 两机 16 卡 PD,76.6–114.7ms 来自 H20 单机 8 卡;不能混入“8 卡对 8 卡”的表。C1/MR2、ctx256K 的功耗对照另见下段,不混入 C4 表。
首次新形状的 JIT/AutoTune 曾使 50K 请求从 23.3s 降到后续约 7.0s。它说明需要区分编译冷态与缓存冷态;进程重建、缓存清理或形状变化后仍可能再编译,不能叫“永久热态”。
独立的单请求探针仍有参考价值:50K 输入、输出 8、N1/C1、MR2、ctx256K,两侧按同参数比较。归档报告给出热态输入速率 6000D 7,063、H20 3,214 token/s,约 2.2×;本地 NT73 日志也保留 6000D 两轮热态耗时 7.16/7.00 秒。该速度含少量输出与端到端开销,不是纯 kernel FLOP/s。
该探针的功耗归一化比值为 25.1/10.2,约 2.5×,按来源定义保留。分母为 dmon 压测窗的板卡功耗汇总口径(6000D 278–283W、H20 316–320W),不是整台服务器输入功率;不能改写为整机能效提升。来源为《四档全矩阵报告》§3.1,6000D 侧 NT73 本地原件可复核,H20 侧沿用报告的 O5 摘要。
冷形状首轮的方向相反:同份归档报告记录 H20 2,892、6000D 2,148 输入 token/s,H20 约快 35%。因此应同时保留冷启动成本和热态优势,不把其中一项当成通用硬件排名。上述探针的总/输出 TPM 未从完整两侧账本独立复算,本文记 N/A,不按目标输出补造。
5.3 单机还是 PD:局部矩阵不是通用阈值
归档 6000D 矩阵中,C4 时单机输入速度比 PD 高约 6.5%–7.8%;C16 轻中档差约 1.5%–1.9%,380K/7K 档 PD 高约 17.6%。这里单机 8 卡、PD 16 卡,C16 两侧 seed 也不同,不能写成等资源、严格逐请求配对。
这组结果提示长输出下可评估 PD;它没有确立“输出≤1.3K 必选单机、≥7K 且 C≥16 必须 PD”的通用规则。输入、输出、并发、槽位、网络和 SLO 都会改变边界。
6. 结论与可复核范围
本次 H20 方案完成了部署与指定测试,最高观察值为 50K/C4N8 总 TPM 1,840,234、输出 TPM 2,791;C64 短档输出 TPM 165,230。两种数字回答不同问题,都不是不带条件的服务产能。
架构上保留机内 NVLink 与跨机 EP 的真实通信关系;容量上区分 KV 存量和调度槽;性能上保留已测改善与退步,把硬件最优、20 人无排队、缓存费用倍数和单一瓶颈等推断与实测分开。
系列目录
- KV Cache 与前缀缓存:从原理到 99.9% 命中率的生产实践
- PD 分离实战:Prefill/Decode 拆池、配比拐点与容量规划
- GPU→内存→SSD 三级 KV 缓存:Mooncake 分层实战与跨引擎复用陷阱
- Kimi-K3 原始 MXFP4 权重512K 长上下文生产部署:双机 16 卡 TP8×PP2 与 CUDA Graph 调优
- 大模型压测方法论:如何让性能数据可信
- 推理集群可观测性:64 卡监控体系与缓存证据链
- MiniMax-H3视频生成服务化:ComfyUI 多 GPU 编排与长任务生命周期
- 掉卡排查实录:RTX 5070 反复 Xid 79,如何排查建立证据链
- GPU对调定位法:8 卡 RTX 6000D 掉卡,如何用对调缩小故障范围
- CUDA 802 不是 NCCL 网络故障:H20 NVSwitch 物理链路排查实录
- DeepSeek-V4.1-Flash 双机 16 卡 H20 部署压测:TP8×DP2 与跨机 EP 的边界(本篇)
数据声明:本文数据来自受控内部环境,各阶段均有限定启动/推理额度并闭账;单次观测不构成稳态产能承诺。文中所有 TPM 均标注档位、并发与请求数,跨报告数字不可直比。