GPU→内存→SSD 三级 KV 缓存:Mooncake 分层实战与跨引擎复用陷阱
大模型推理基础设施实战系列 · 第 3 篇
1. 背景与问题:GPU 显存装不下所有"值得记住"的前缀
第 1 篇我们看到前缀缓存能把 48 万 token 文档的 TTFT 从 421 秒降到 2.76 秒。该例属于 vLLM 双机 H20。后续 C4 配置的 KV 池与 512K 窗口之比约 2.25,最多只能按两条完整窗口作粗略容量理解。它不是 SGLang Radix 树的通用容量,具体何时驱逐取决于请求长度、共享前缀和策略。
自然的想法是分层:挤出的块不丢,先备份到主机内存(DRAM),再溢到共享存储(其他节点的内存 + NVMe SSD)。只有取回状态正确、传输与资源竞争的总成本低于重算时,才有净收益。这就是 SGLang HiCache 的 L1/L2/L3 与 Mooncake Store 的组合,也是 vLLM 的 KV Offloading 连接器(TieringOffloadingSpec)要做的事。
2. 技术选型:两条引擎路线都走了一遍
| 路线 | 组合 | 验证结果 |
|---|---|---|
| SGLang + Mooncake | L1 GPU Radix → L2 Host → L3 Mooncake Store(RAM 段 + 本地 NVMe) | 配对取得:SSD 开 vs 关 TTFT 3.99×/4.85×;经历线程洪峰后完成测量 |
| vLLM + TieringOffloadingSpec | GPU → CPU(/dev/shm 512 GiB)→ fs(数据盘目录) | RAM 层单引擎生命周期内 9/9 正确;fs 层跨引擎复用 2/2 正确性失败,不可推荐 |
两条路线覆盖了"共享存储服务"和"引擎内置连接器"两种形态,踩的坑完全不同,可以展示两类常见风险,不能视为穷尽所有实现。
3. 架构设计:三级缓存与两个方向的数据流
理解这个架构,关键是分清两个方向、三种证据:
- 备份方向(GPU→Host→Store):通常异步进行,但仍可能竞争 CPU、内存带宽或 I/O,不能保证对 decode 零影响。注意指标语义:
hicache_backup_bytes_total是 GPU→Host 的字节,Host→Store 看backuped_tokens_total——方向搞反会把备份流量当命中流量。 - 预取方向(Store→Host→GPU):先查元数据(GetReplicaList),命中后传输、插入 Host,最终供 prefill 复用。“查询命中”“传输完成”"最终复用"是三个阶段——预取成功后仍可能被丢弃(如第 1 篇的辅助状态不完整),传输计数不能当命中量。
- 三种证据各说各话:引擎最终复用 token(GPU/Host/Store 三层)、Store 元数据返回来源(RAM/SSD)、块设备物理 I/O。"Store 命中"可能由 RAM 段满足,应用层文件读取也可能命中 OS 页缓存——证明 NVMe 真正发挥作用,必须同窗看物理读盘字节。
容量算式也要算对。global_segment_size=274,877,906,944(256 GiB)在我们部署中是每副本的 Store RAM 总配额:适配器先除以 TP×PP=32,得每 rank 8 GiB、每节点 64 GiB、每副本 256 GiB。它不是每节点 256 GiB,更不是 master 进程自己占用。
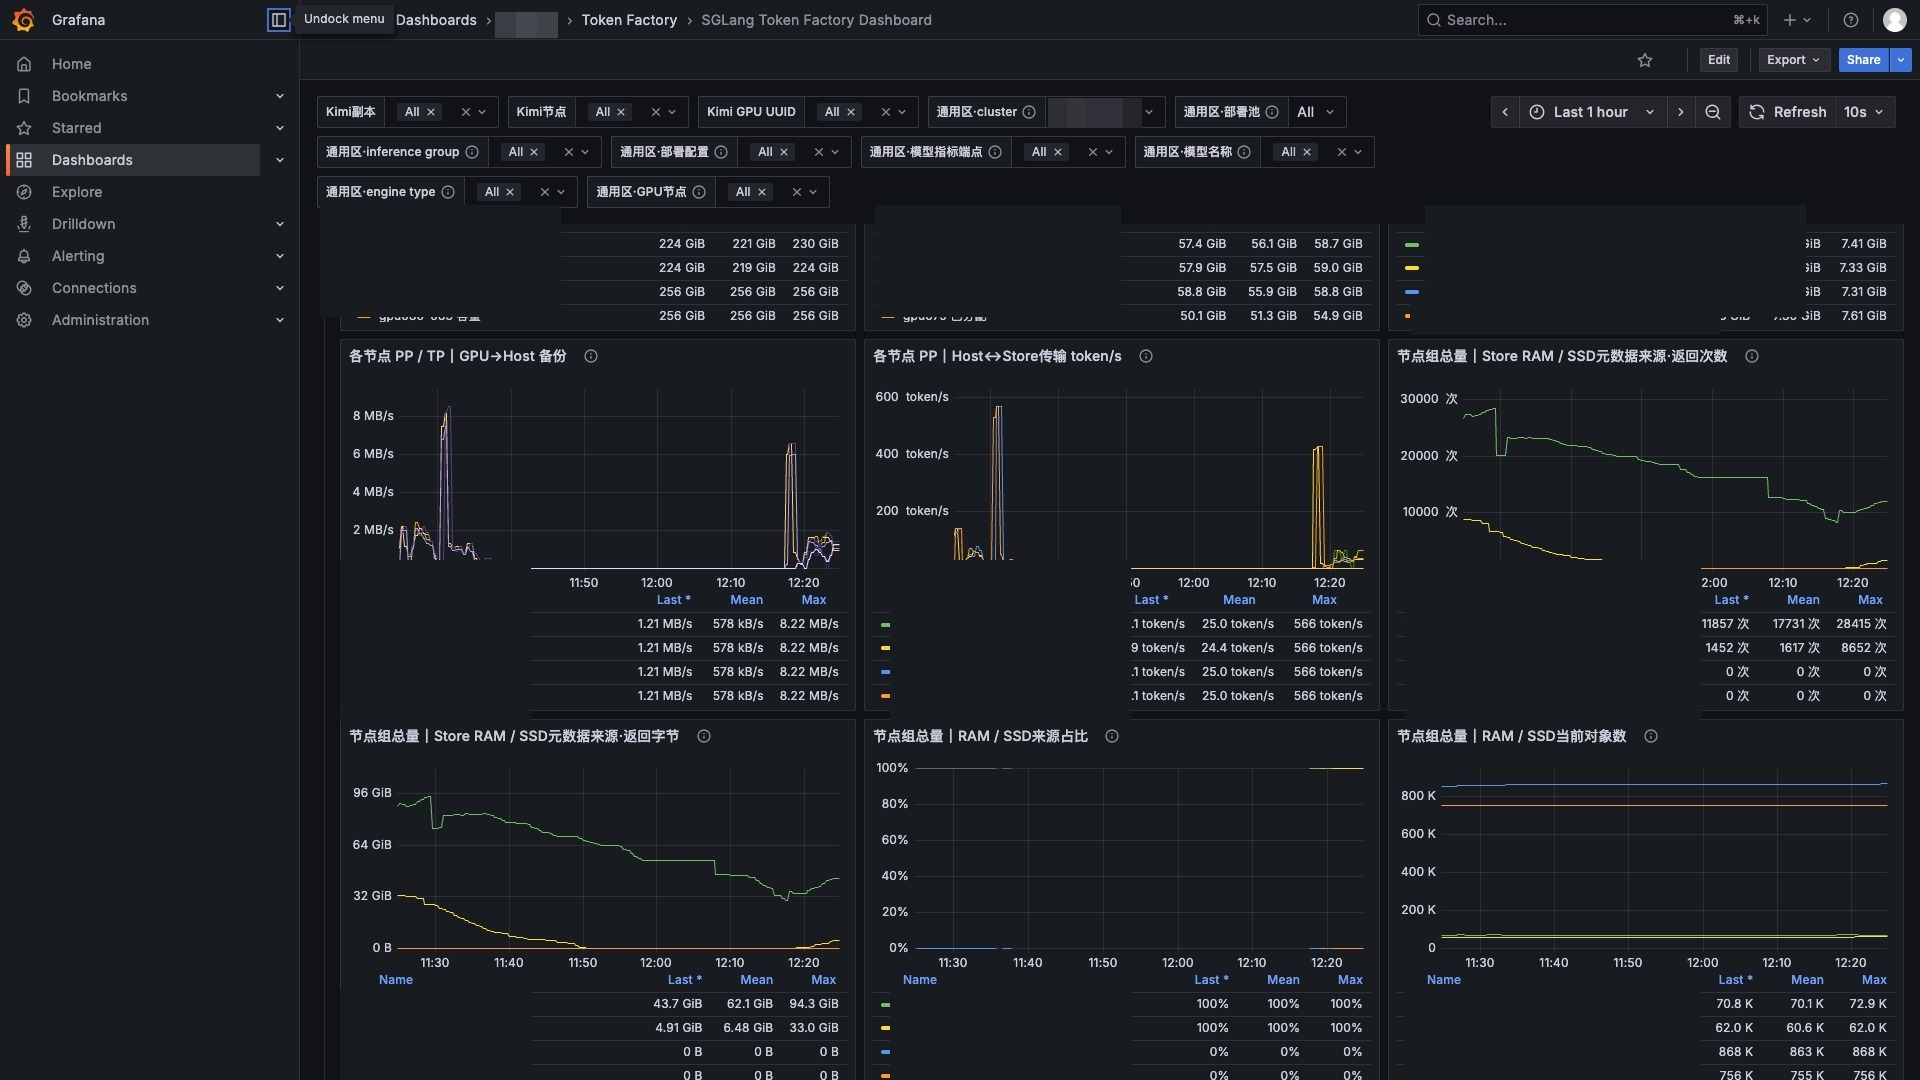
生产看板上两个方向的曲线同窗呈现(历史流量窗口截图,已脱敏):左列 GPU→Host 备份(MB/s)与 Host↔Store 传输(token/s)的尖峰,对应一次次的备份 / 预取事件;右列 Store 元数据来源按 RAM / SSD 分开计数与占比——本窗口返回 100% 由 RAM 段满足,这就是"Store 命中 ≠ NVMe 读盘"的直接证据:
4. 核心实现与实测:SSD 开 vs 关,prefill 快 10 倍
4.1 实验设置
- 模型与硬件:GLM 系 Flash 模型,单机 8×RTX 6000D(TP8/EP8/PP1,C1,196K 上下文,KV FP8);
- 配对设计:关缓存 = 纯冷请求(三层复用均为 0);开缓存 = 同一内容第二程,命中部分的 KV 经本地 NVMe 路径读回(响应权威归因 device=0、host=0,物理读盘 456.8 MB / 1,060.7 MB 同窗取证);
- 落盘设置与核验:每桶 1 key 封桶(
MOONCAKE_OFFLOAD_BUCKET_KEYS_LIMIT=1)——默认 500-key 桶曾导致缓存写不完整。
4.2 配对结果
| 输入 / 模式 | TTFT(s) | prefill(s) | 总 TPM | 输出 TPM | Store 命中 |
|---|---|---|---|---|---|
| 50,000 / 关 | 5.826 | 5.812 | 124,799.39 | 635.72 | 0 |
| 50,000 / SSD | 1.461 | 0.557 | 151,890.64 | 773.72 | 99.84% |
| 160,000 / 关 | 19.274 | 19.247 | 255,406.99 | 408.00 | 0 |
| 160,000 / SSD | 3.978 | 1.810 | 430,446.70 | 687.61 | 92.16% |
固定输出 256 token,各格 n=1。关为旧配置基线,开为第 9 次启动的新配置;两条新配置冷请求 TTFT 与旧基线相差 +1.1% / −0.1%,支持可比性,但不等于严格单变量同进程配对。160K 有 12,544 token 未命中并重算。候选使用官方底座加冻结补丁,不能标为原版官方制品。
三个诚实的注脚(这种注脚应该成为性能文章的标配):
- 未观察到明确的 decode 提升;旧配置配对约 13.87 vs 13.91 token/s,同一新配置内反而慢 1.6%–2.9%。每格 n=1,不能确立小差异或宣称机制上完全不变;
- 160K 的命中率是 92.16% 而非 100%:封存缓存在灌入期有 7.84% 尾部切片未落盘(异步持久化截断),原活动从未回读过 160K,本次首读才发现——缓存在你不读的时候不会自证完整;
- 这两个长度点的总速率收益分别为 +21.7% 与 +68.5%,不外推单调规律;注意力复杂度、命中比例和传输开销都会改变收益。
缓存证据看板的实际样子(另一个 8 节点、双副本部署的同窗数据:各节点 GPU 复用 token、Host 复用、Store 复用与 NVMe 物理读写同表对照;主机名已马赛克脱敏):
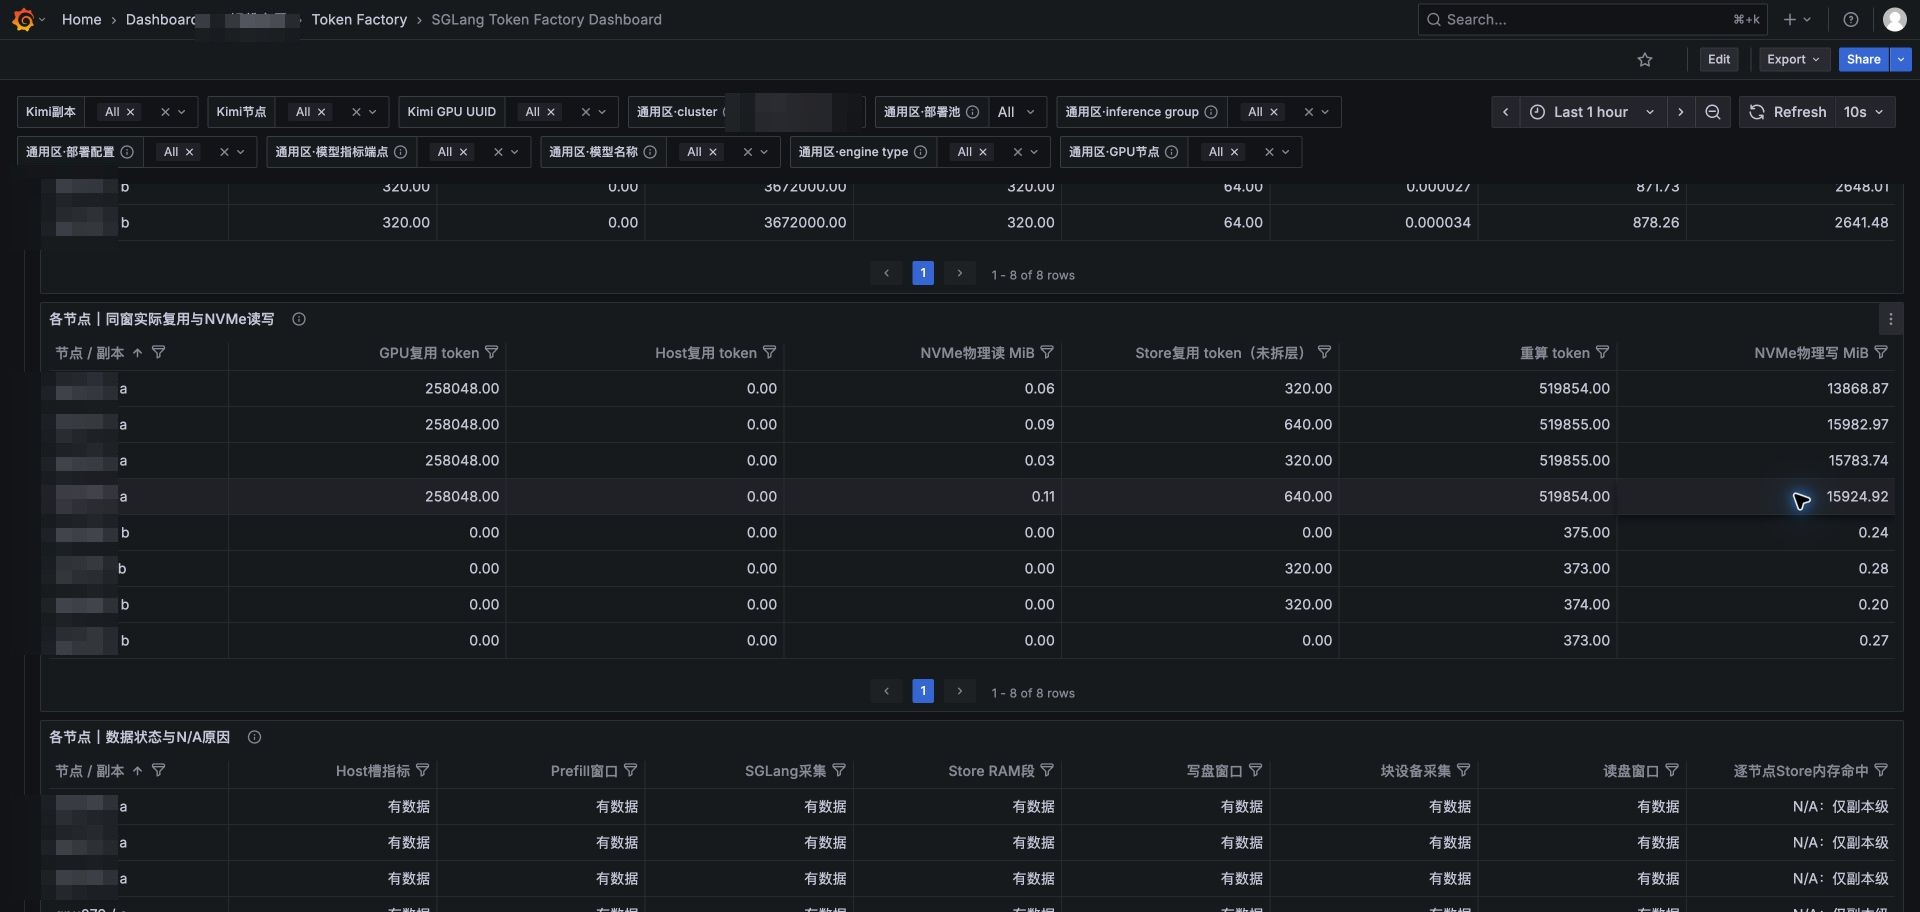
注意表中最右两列:Store 复用 token 很高的节点,NVMe 物理读却只有 0.03–0.11 MiB——这正是"Store 命中不等于发生 NVMe 读盘"的实例(命中由 Store RAM 满足);而发生 SSD 恢复时,物理读可以达到单节点 15 GB 以上。两类窗口必须分开判断。
5. 难点一:SSD 读路径的线程洪峰,一次由 pids.max 引发的"性能调查变内核调查"
第 4、5 次启动已出现 pids 限额事件;1,556→3,397 的 30 秒轨迹属于第 8 次启动的调度器线程采样。cgroup 总任务上限为 4096,采样未捕获全部瞬态峰值,不能把 3,397 说成等于 4,096。
定位过程是"把模糊故障拆成可验证假设"的样板:
- 拦截取证:LD_PRELOAD 拦截
pthread_create,8 进程并发复现——2.4 秒内 2,323 次线程创建,2,072 次来自同一创建点;std::__future_base符号佐证 std::async 路径; - 根因定性:Mooncake 客户端 store.so 的 SSD 读路径按 I/O 单元创建 std::async 瞬态线程,扇出 ≈ key 数 × 61 层 × 并发 × 重试次数;本次核查的命名线程池环境变量没有约束这个瞬态扇出;
- 排除嫌疑:SGLang 分块补丁经 A/B 证伪未注入(chunk=4 与 196 峰值相同);命名线程池(fileread/memcpy/RPC)有界无泄漏;OMP 未封顶只抬高基线(191→15 线程/进程,
OMP_NUM_THREADS=8解决); - 处置(测量杠杆,不改代码):预取重试 8→1(关掉最大放大器)、pids-limit 4096→16384、OMP=8。补测全程峰值 4,312 线程;50K 与 160K 两个已测点峰值相同,pids.max 事件 0,4/4 完成。
长期修复应约束客户端 I/O 扇出,有界线程池是候选实现之一——本轮只证明了这个杠杆组合下可以安全完成测量,两者不能混为一谈。
6. 难点二:跨引擎复用的正确性事故——“快了,但答案是错的”
vLLM 0.31.0 路线(Kimi-K3,双机 H20,TP8×PP2,256K/C8)验证 TieringOffloadingSpec 时,我们先是拿到了一个好结果:
- RAM 层(/dev/shm 512 GiB):单引擎生命周期内 9/9 正确。 5 篇互异文档把首篇挤出 GPU 池后重发,CPU 层命中,TTFT 3.68 秒 vs 重算约 180 秒(约 49×),答案正确——GPU→CPU→GPU 往返在本引擎生命周期内验证可用。
32 GiB 阶段已启用 fs 副层,但只观察到写入,尚未验证从盘恢复。随后把 UVA 卸载降到 24 GiB 并重启引擎,继续挂载原 fs 目录时,事故发生了:
两条全新的、互异的冷文档(与任何已存内容的合法公共前缀不足 1 块)都给出了错误答案。连接器计数揭示了机理:
每条冷请求从下层被提升了 49.88 GB 不属于本请求的块(CPU→GPU 计数 16→32),TTFT 约 93 秒(重算的一半),模型把文档感知为无关乱码。
磁盘持久化也不对称:节点 01 写入约 280 GB / 1765 文件,节点 02 为 0——这是不对称写入的观察,不能仅凭它定位到 PP2 半状态缺失的根因;缓存 key、生命周期隔离和状态恢复实现仍需源码级复现。
结论按最坏口径发布:数据盘 fs 层跨引擎复用,在该混合模型(KDA+PP2)上不正确,2/2 失败,不可推荐。 该阶段受控停止。随后清净 fs 后重新启动同配置,2/2 全新冷探针正确、无 CPU→GPU 提升,支持陈旧缓存污染判断;这不等于跨引擎恢复被修好。
运维教训(每条都对应一个真实故障)
- 死引擎会在 /dev/shm 泄漏
vllm_offload_*.mmap(单机 512 GiB):重启 KV 分层前必须核对对应引擎的 mmap 文件,并用lsof等确认无持有进程,再精确清理已归属的泄漏文件——首次启动失败正是因为泄漏段占满 shm; - fs 层目录必须按引擎生命周期隔离:核对归属、占用与保留需求后清理该引擎目录,或按实例使用新目录,否则冷文档会命中上一引擎的残留块;
- PP 成对生死:PP2 一侧死亡后另一侧空转(NCCL Broken pipe + 高 CPU),不做"半活"等待,直接受控停止。
7. 效果与总结
| 层级 | 验证结论 | 适用边界 |
|---|---|---|
| vLLM CPU 层(H20 个案) | 单生命周期 9/9 正确,暖恢复约 49× | 跨重启不保证;混合模型辅助状态需单独验收 |
| L3 Mooncake SSD(SGLang) | prefill 10.4×/10.6×,TTFT 3.99×/4.85× | 需桶配置保证完整落盘;读路径扇出需杠杆约束;本次未确认 decode 提升 |
| fs 层跨引擎复用(vLLM 连接器) | 2/2 正确性失败,不可推荐 | 混合模型 + PP2 实测;恢复需清目录 + 冷探针专项验证 |
四条带走的经验:
- 本次主要收益来自减少重复 prefill——用它解决"重复读长文档",别指望它解决"生成慢";
- 缓存完整性与正确性是两道独立的门:落盘不完整(92.16%)只是收益打折,取回错块(49.88 GB)是答案错误——前者看命中率,后者必须看回答内容;
- 性能故障可能是资源限额故障:洪峰表象是"读 SSD 变慢",根因是扇出 × 重试 × pids.max;LD_PRELOAD 拦截是低成本高确定的取证手段;
- 每次"命中"都要追问是哪一层、哪个阶段——查询命中、传输完成、最终复用、物理读盘是四件事(第 6 篇展开)。
下一篇换一个视角:当单副本跨两台机器、上下文拉到 512K 时,部署与调优的完整过程——Kimi-K3 原始 MXFP4 权重 512K 长上下文生产部署:双机 16 卡 TP8×PP2 与 CUDA Graph 调优。
系列目录
- KV Cache 与前缀缓存:从原理到 99.9% 命中率的生产实践
- PD 分离实战:Prefill/Decode 拆池、配比拐点与容量规划
- GPU→内存→SSD 三级 KV 缓存:Mooncake 分层实战与跨引擎复用陷阱(本篇)
- Kimi-K3 原始 MXFP4 权重512K 长上下文生产部署:双机 16 卡 TP8×PP2 与 CUDA Graph 调优
- 大模型压测方法论:如何让性能数据可信
- 推理集群可观测性:64 卡监控体系与缓存证据链
- MiniMax-H3视频生成服务化:ComfyUI 多 GPU 编排与长任务生命周期
- 掉卡排查实录:RTX 5070 反复 Xid 79,如何排查建立证据链
- GPU对调定位法:8 卡 RTX 6000D 掉卡,如何用对调缩小故障范围
- CUDA 802 不是 NCCL 网络故障:H20 NVSwitch 物理链路排查实录
- DeepSeek-V4.1-Flash 双机 16 卡 H20 部署压测:TP8×DP2 与跨机 EP 的边界
数据声明:本文数据来自受控内部测试环境,配对单元格多为 n=1,只说明方向;故障案例中的模型/引擎组合、版本均已注明,结论不外推到其他组合。