MiniMax-H3视频生成服务化:ComfyUI 多 GPU 编排与长任务生命周期
大模型推理基础设施实战系列 · 第 7 篇
1. 背景与问题:视频生成不是"换个模型的文本推理"
把视频扩散模型(DiT 架构)做成服务,和文本 LLM 有四个性质差异:
- 任务是分钟级的:标准步数 B2 配置下,15 秒样例等待约 8–11 分钟;实际 8 步加速候选约 2–3 分钟。服务需要异步提交与查询,避免客户端断连绑定任务生命周期;
- 产物是大文件:每片几百 KB 到几 MB 的 MP4,涉及上传素材、原片回传、合成与下载的完整文件链路;
- 并行语义不同:文本模型用 TP/PP/DP,视频 DiT 用 TP/Ulysses/Ring,还有注意力头数整除这类硬约束;
- 质量是多模态的:画质、音画同步、语义一致性都要验收,"协议成功"离"能交付"更远。
我们的任务:把 MiniMax 系视频模型(三种生成模式:纯文本 T2VA、首尾帧 FL2VA、参考素材 Ref2VA)按最多 25 台 8×RTX 6000D 的历史配置范围设计部署,并让非技术用户通过 ComfyUI 画布使用。
本文沿用项目已有测试与工作流记录,补入真实画布截图和成片抽帧:先看一个八卡实例的速度,再看两台实例如何并行,最后用相同步数的产物对照解释加速与质量的取舍。图中界面是历史快照,测量日期、样本量与来源分别注明。
2. 布局选型:270 点矩阵选出 TP2/U4
2.1 硬约束:注意力头数整除
模型 Transformer 为 56 个头,要求 56 % TP == 0 且 (56/TP) % Ulysses == 0,候选布局先被砍掉大半:TP4/U4、TP8/U2、TP8/U4 因头数整除被原生拒绝;TP1/U4 在 VAE 加载时显存不足、0 条生成——容量失败不等于拓扑非法,但同样出局。
跨机 Ring 在本批硬件上无证据(官方跨机配方要求 Ring + encoder replicate),未实测前不推荐。
2.2 矩阵结果
五布局 × 三模式 × 两种时长 × 三档缓存,270 个有效正式样本、90 格三轮齐全、180 对缓存比较:在这五种已测布局内,TP2/U4/Ring1 在全部 18 种对照中平均生成耗时最短;后续 TP2/U1 扩展有 35 项有效、19 项失败,未并入此三轮排名。
下表补齐三模式、两种目标时长,均为单机 8×RTX 6000D、C=1、768p、请求 16:9、请求 50 步(固定实现实际 49 次去噪),每格 3 条有效正式样本。原矩阵固定 SGLang 提交 94602c9c;模型加载和预热另计。
| 模式 | 目标 | 布局/缓存 | 平均耗时 | 折合片/小时 | 8 卡电量 |
|---|---|---|---|---|---|
| T2VA | 5 秒 | TP2/U4 · B2 | 83.25 s | 43.24 片/小时 | 55.86 Wh/片 |
| T2VA | 15 秒 | TP2/U4 · B2 | 456.02 s | 7.89 片/小时 | 288.19 Wh/片 |
| FL2VA | 5 秒 | TP2/U4 · B2 | 98.31 s | 36.62 片/小时 | 63.48 Wh/片 |
| FL2VA | 15 秒 | TP2/U4 · B2 | 485.15 s | 7.42 片/小时 | 306.15 Wh/片 |
| Ref2VA | 5 秒 | TP2/U4 · B2 | 194.69 s | 18.49 片/小时 | 124.40 Wh/片 |
| Ref2VA | 15 秒 | TP2/U4 · B2 | 659.46 s | 5.46 片/小时 | 416.50 Wh/片 |
这里的耗时从正式提交计至首次观察到完成,包含接口与轮询误差,不含下载、解码。片/小时是逐轮 3600÷耗时 后取均值的单位换算;Wh 只计正式窗口内八张 GPU 的板卡电量,不含 CPU、整机和制冷,也没有连续一小时产能验收。来源为 C06/C21/C36/C51/C66/C81 的 18 条原始记录。
B2 是缓存档位:Cache-DiT 的残差差异阈值为 0.12;B1 为 0.06,A 为关闭。它既不是“12% 命中率”,也不代表启用 LoRA。第 5 节的公开加速配方是另一组实验,不能把两阶段的耗时直接相除归因为某一个组件。
结论定为:一台 8 卡服务器 = 一个算力单元 = 一个完整实例,实例内串行处理(C=1)。要多并发就加整机副本,不把单点 QPM 乘以 25 冒充集群实测。缓存档 A(关闭)作为输出基线,B1/B2 有实测提速但需业务画质验收后启用。
3. 服务链路:GPU 节点不装 ComfyUI
3.1 编排与推理分工
链路设计的三个要点:
① 职责分离。 GPU 节点只跑推理环境、模型、输出目录和受保护的原生 API;ComfyUI 服务端放在独立 CPU 服务器上,只做工作流编排(提交、编码、预览、下载),不加载模型。GPU 镜像保持干净,有助于隔离 ComfyUI 与推理环境的依赖。
② 两段独立 Key 鉴权。 客户端经 Key 登录 ComfyUI 服务端;服务端携带对应实例的 Bearer Key 调用原生 API。公网只映射 ComfyUI 入口,GPU 端口只走内网——客户端不需要、也不应该直达 GPU 私网。
③ 显式 URL 选实例,无自动负载均衡。 画布可填多个获准实例的 URL,复制分支即可两片并行(已验证:两台实例推理分别 83.103/83.314 秒、完整解码通过)。但同一实例 batching-max-size=1,100 个请求写进同一 URL 不会分散到别的机器;25 路同窗产能、跨用户公平排队尚未验收,我们不声称已具备。
3.2 真实画布:素材、编码、提交与结果分区
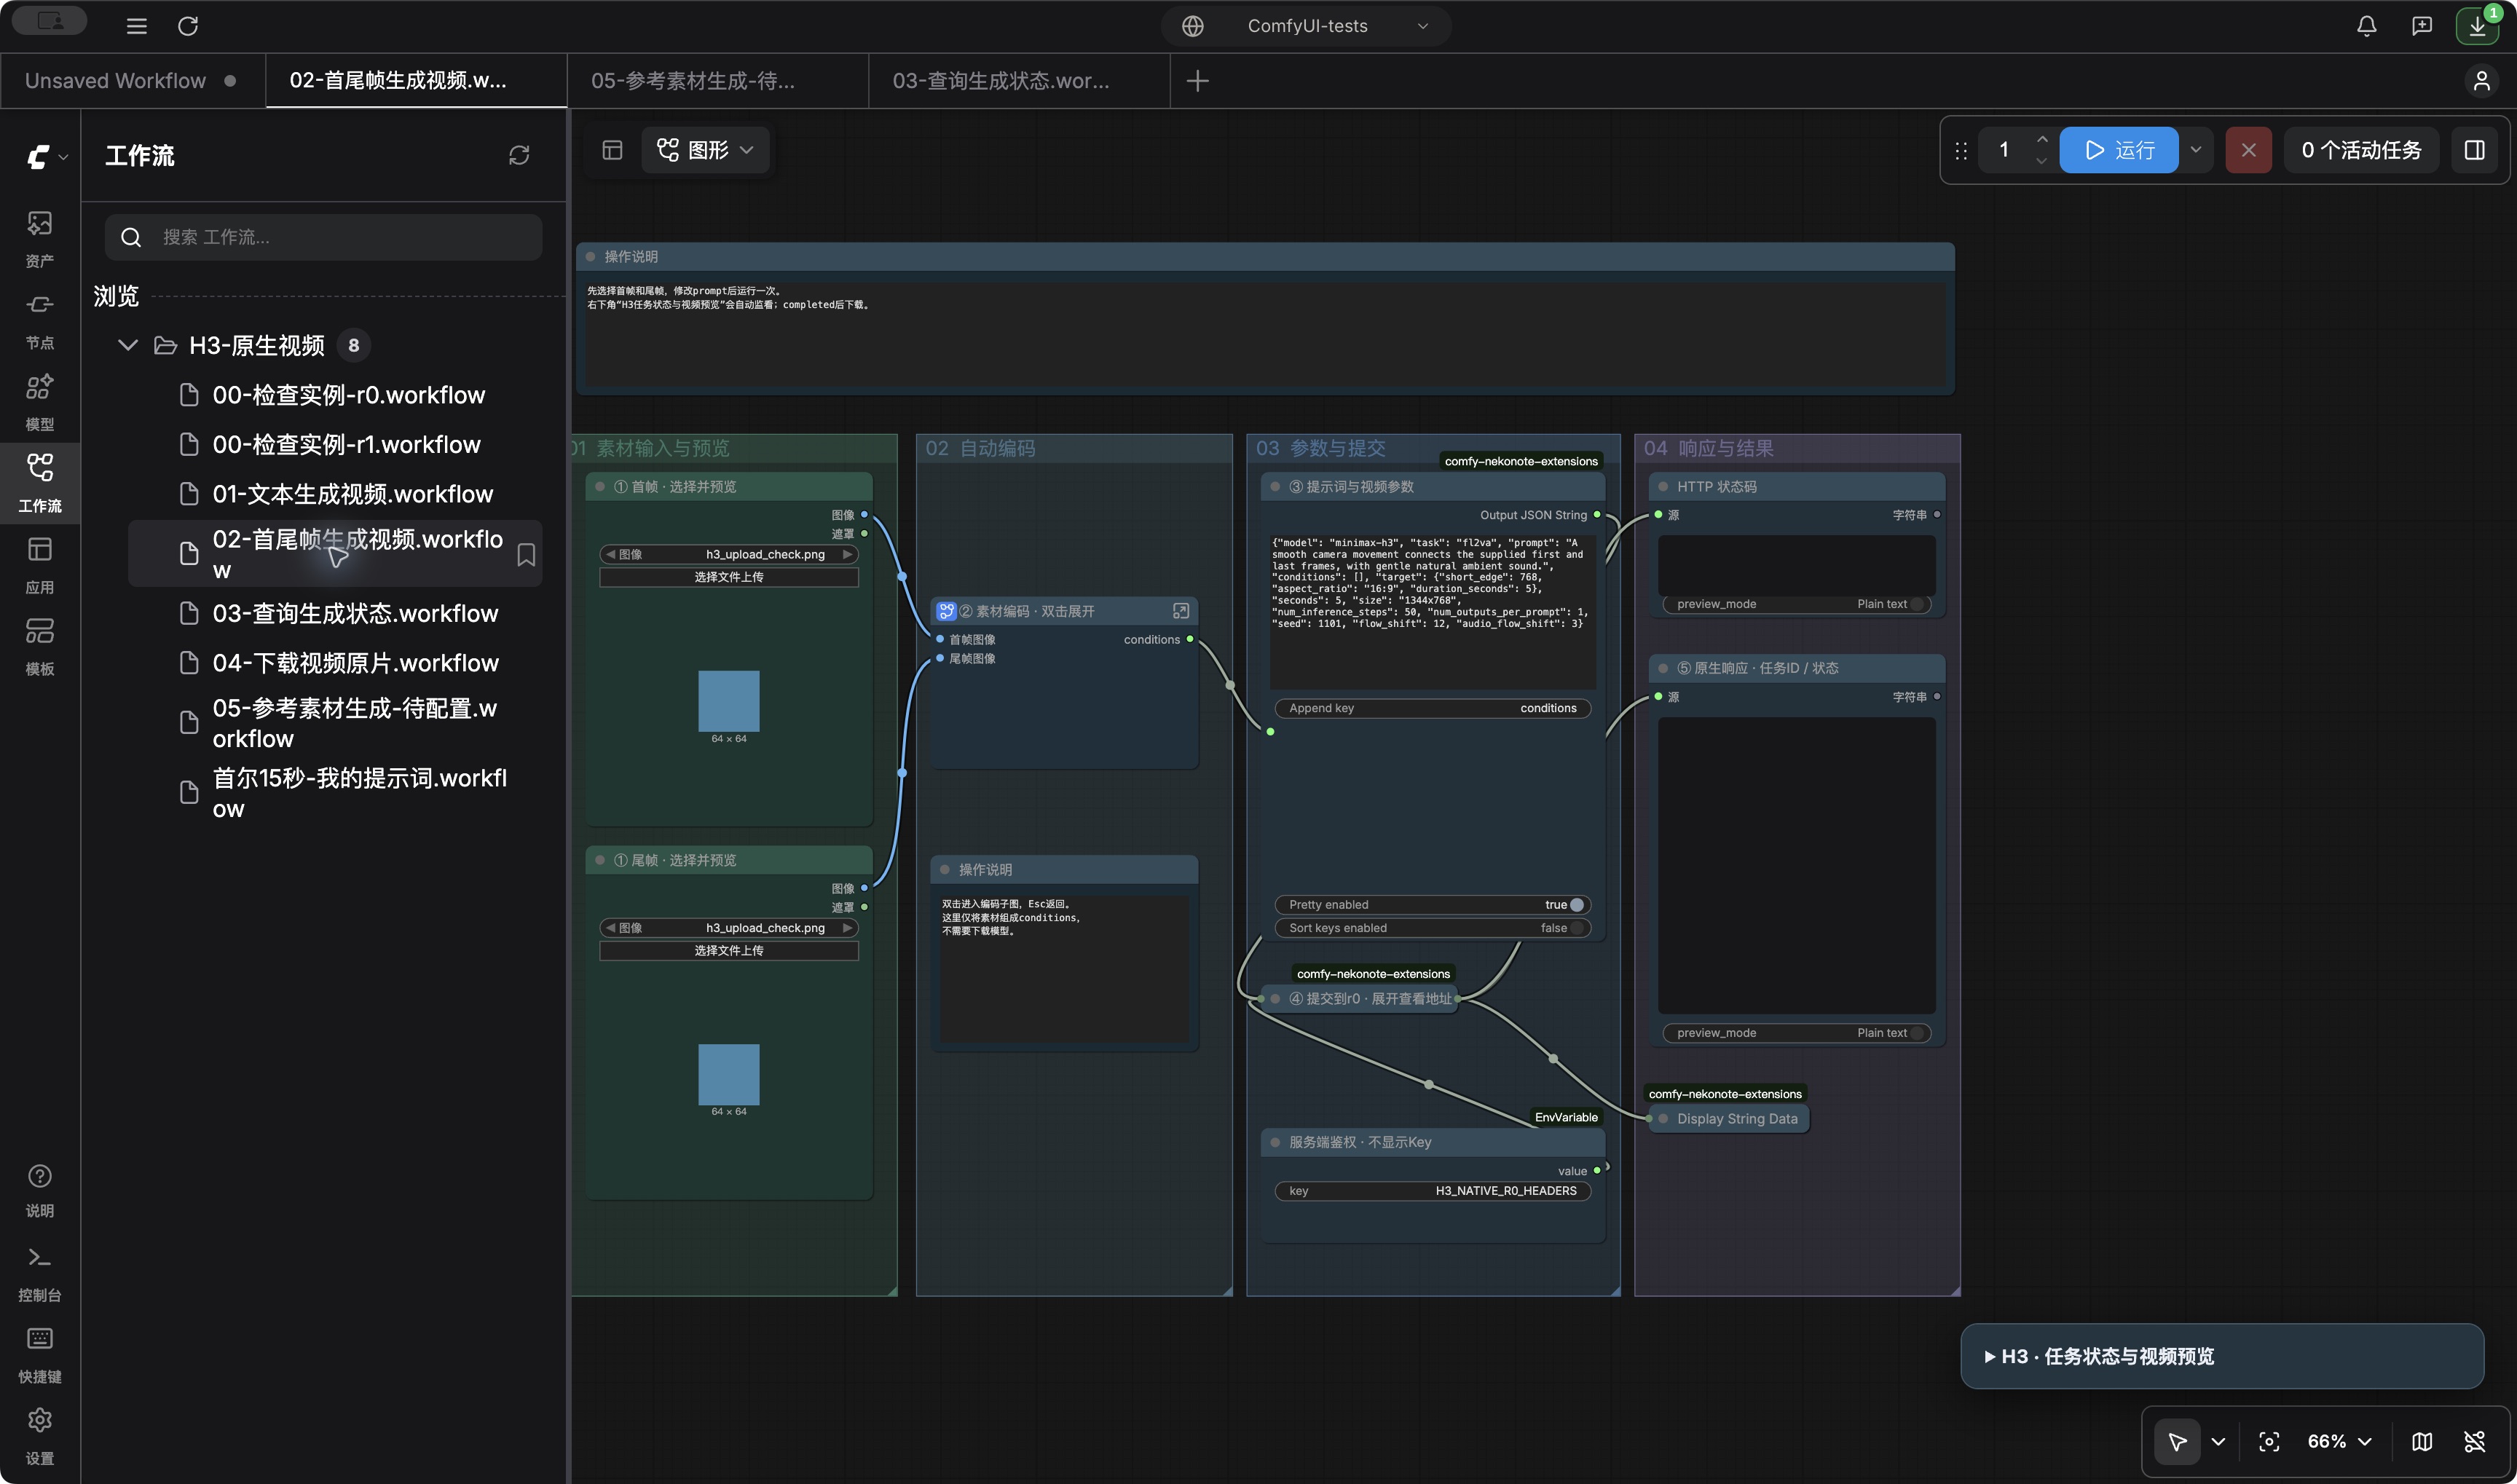
图 1|项目保存的「02-首尾帧生成视频」画布。左侧选择首尾帧,中间把素材编码为 conditions 并组装请求,右侧接收状态码与任务 id。蓝色色块是当时的上传检查素材;截图展示节点组织,业务制作时换成自己的图像。来源:ComfyUI 接入教程。
这张图把容易混淆的动作分开了:点一次运行只负责提交;拿到 id 后由状态面板查询,completed 后再下载。鉴权节点读取服务端环境变量,画布里保存变量名。用户无需把明文 Key 放进可分享的工作流。
3.3 两条分支怎样变成两路真实生成
2026-10-09 的功能验收在同一画布点一次运行,两条无依赖分支各提交一次。两端均为 TP2/U4、B2;目标 5 秒、768p、请求 50 步、seed=1101,每台一条请求,未重试。
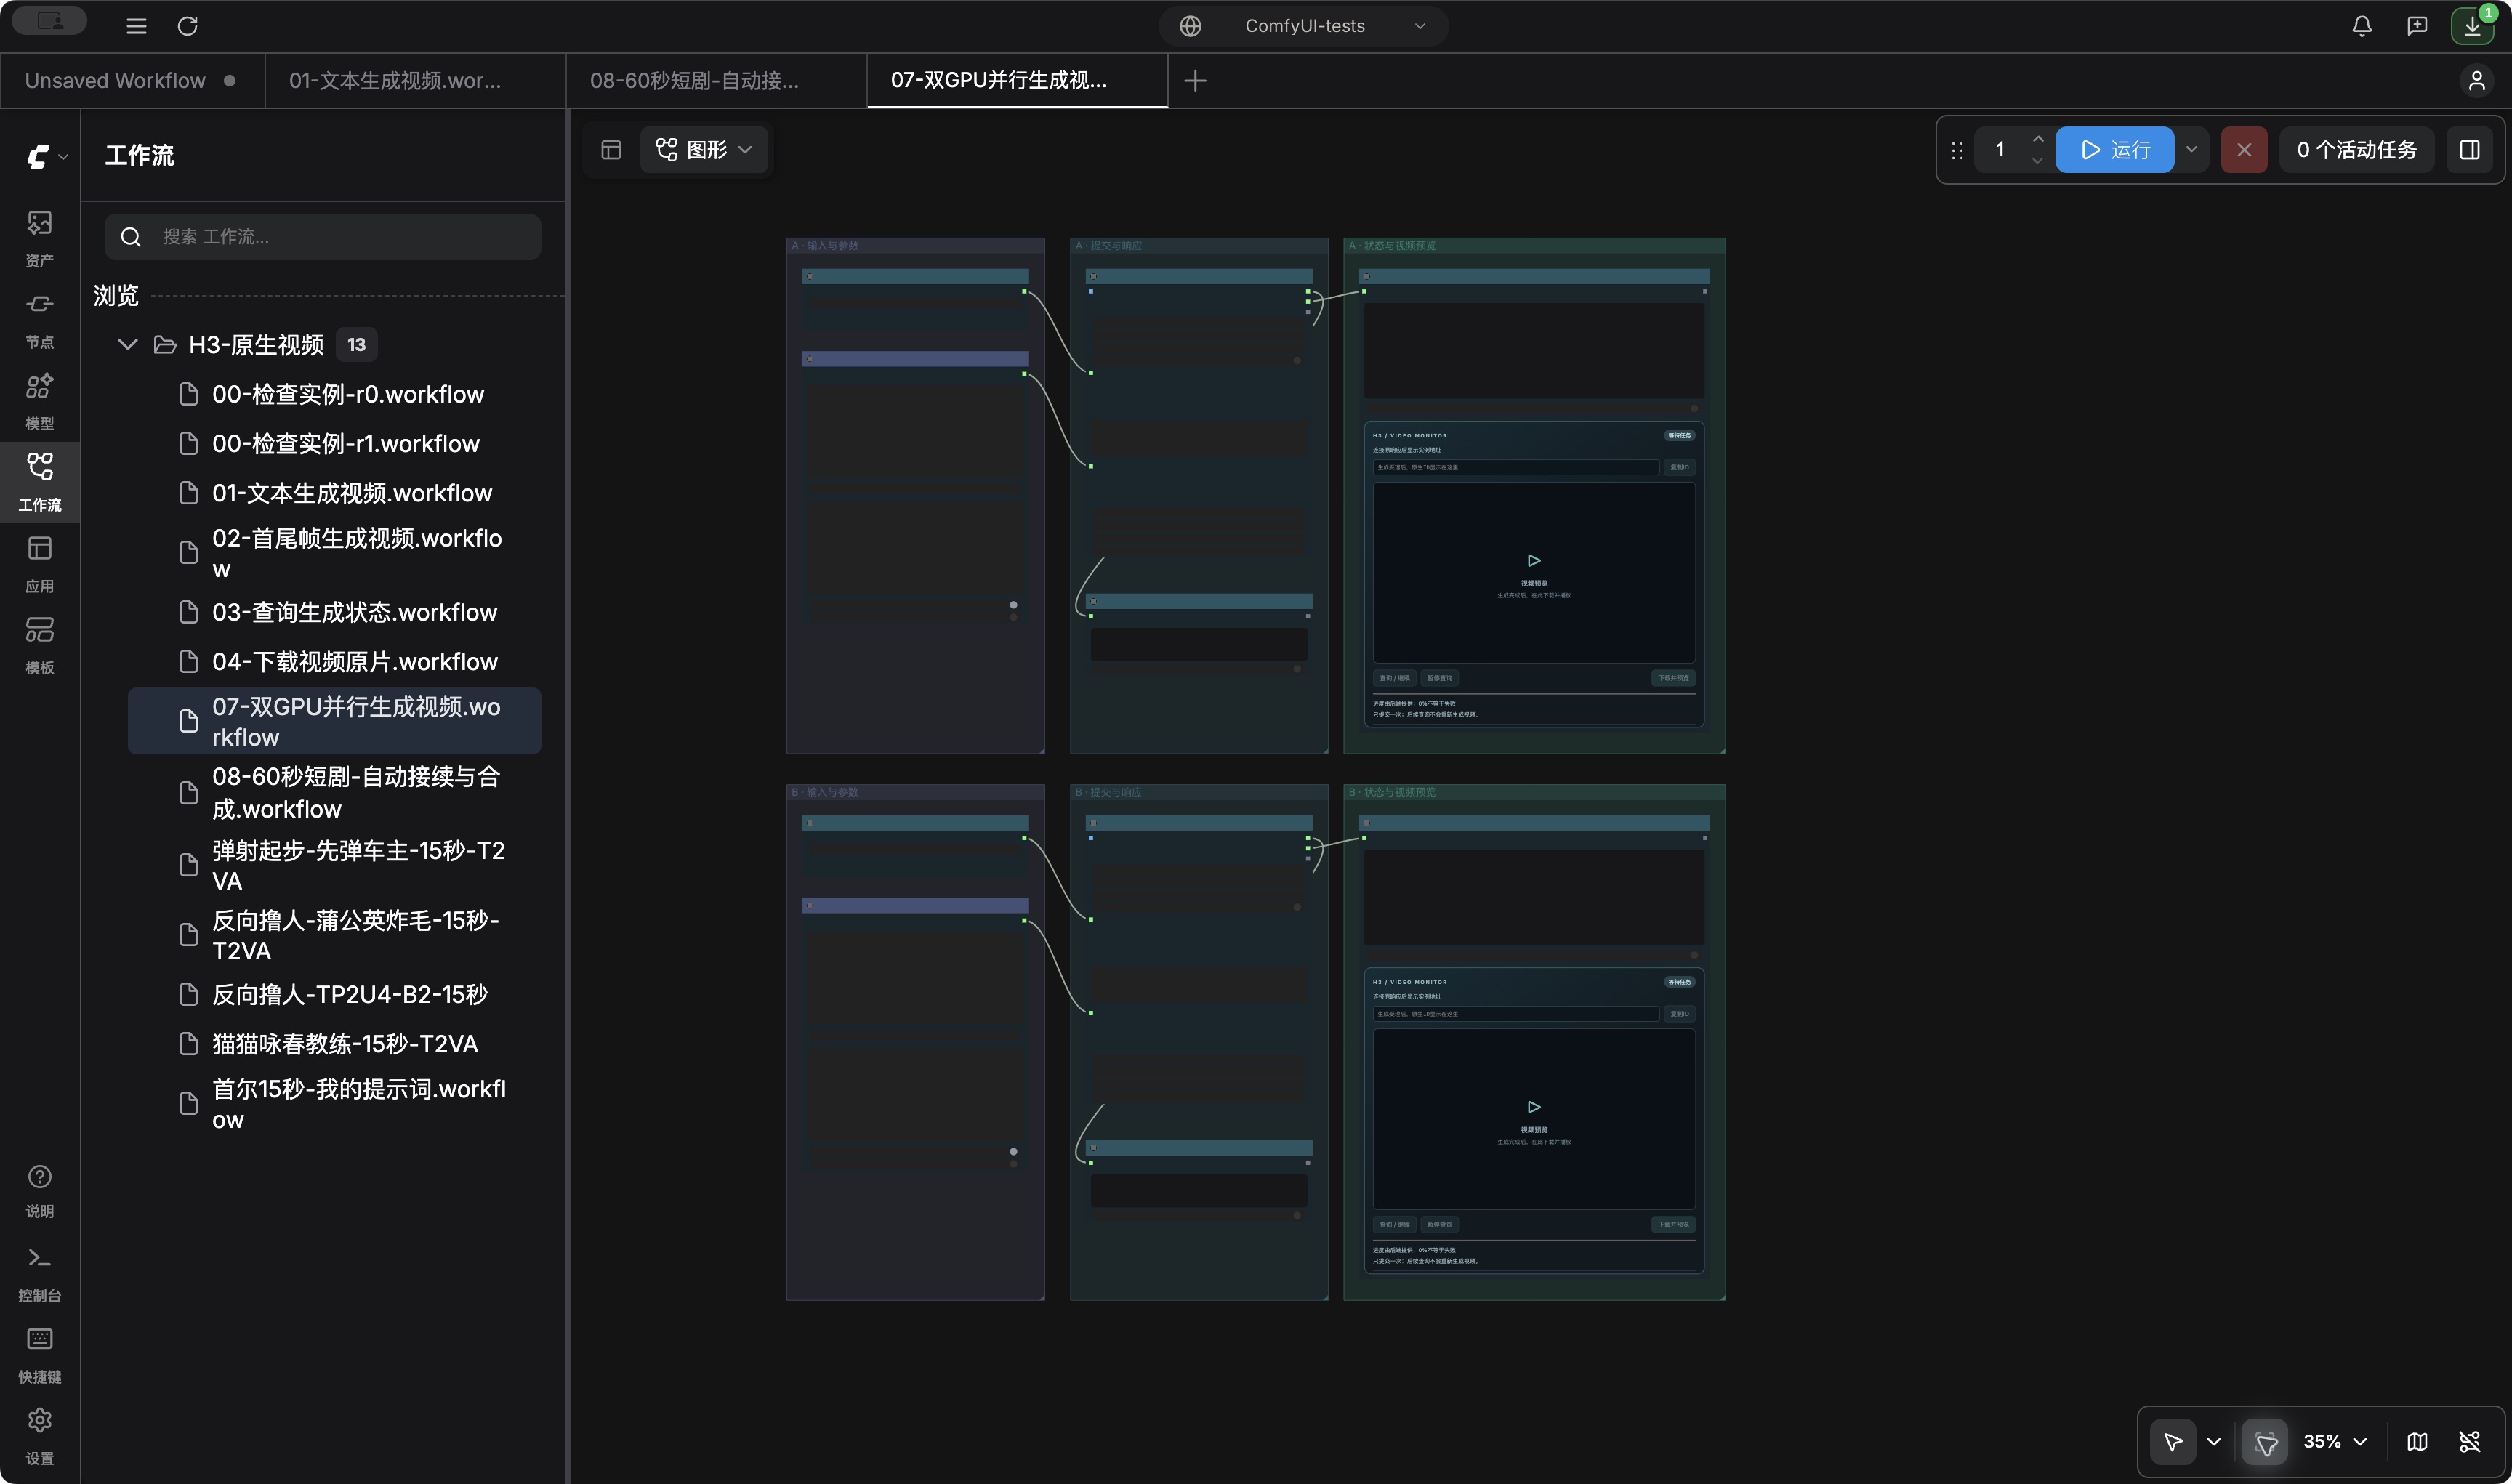
图 2|「07-双GPU并行生成视频」的历史画布结构:A、B 各有输入、提交、状态与预览。名称中的“双GPU”实际对应两台独立八卡实例,合计 16 张卡;不是两张单卡各跑一个完整模型。图示为节点布局,实际出片验收见下表。
| 分支与内容 | 后端原生推理时间 | 下载后实际视频 | 完整性验证 |
|---|---|---|---|
| 实例 A:竹林中的小熊猫 | 83.103 s | 1344×768,24 fps,124 帧,5.166667 s | 完整音视频解码通过;三端 SHA 一致 |
| 实例 B:落日海面的白色帆船 | 83.314 s | 1344×768,24 fps,124 帧,5.166667 s | 完整音视频解码通过;三端 SHA 一致 |
两条任务记录的整数创建/完成时间相同。约 5 秒一次的采样中,取得 16 组相隔不足 2 秒的跨节点样本,每组两台全部 8 卡利用率均≥90%,支持两台生成发生重叠。83 秒是后端原生推理时间,不等于 Mac 点击到播放的总等待;离散 GPU 采样也不是逐毫秒计时。
两片均带 AAC 双声道音轨,GPU 源文件、CPU ComfyUI 下载文件和 Mac 文件摘要一致。该次 2 条功能请求独立于性能矩阵;证据见教程中的双实例验收与验收记录的 canvas_parallel_validation 字段。
4. 难点一:异步任务的生命周期管理
原生 API 是三件套:POST /v1/videos 拿回 id → GET /v1/videos/{id} 查状态 → GET /v1/videos/{id}/content 下载。围绕它的纪律:
- id 与实例绑定:查询和下载必须回到当初提交的实例及配置代次,切换 GPU 查同一个 id 是查不到的;
- 失败与 unknown 分开:收到明确 failed 保留原错;POST 超时、worker 失联等"受理不明"进入核查状态——先核已有任务,禁止自动重发或改投另一台 GPU 重复生成(重复生成的代价比失败大得多);
- 进度要诚实:API 只有 queued/completed/failed 三态,没有连续进度时,界面显示等待时长和查询新鲜度,标注为估计,不填造百分比;queued 也不等于"还没开始"。
最大的坑是 VIDEO_STORE 是内存索引:MP4 写到了磁盘,但 worker 重启后,原查询和 content 接口对历史任务可能失效。这意味着"文件持久化"和"任务可查询/可下载"是两件事——生产化必须另建任务元数据 + 产物归属 + 文件位置的持久索引,并按任务所有者鉴权下载。
5. 难点二:公开加速配方的严谨评估
5.1 把步数对齐,再比较完整配方
公开候选组合了 Turbo LoRA、SageAttention2 和 torch.compile。2026-10-14 的评估把实际步数对齐:三模式 × 4/6/8/10/12 实际步数 × 5/15 秒,开/关配对,60 条正式、30 组配对,每格 n=1,B2 在开/关两侧均开启。OFF 为 Torch SDPA、无 Turbo LoRA、无编译;ON 同时开启上述候选组件。
两侧均为同一台 8×RTX 6000D、TP2/U4/Ring1、C=1,同模式配对的输入、请求和种子相同。T2VA 种子 2101,FL/Ref 种子 1101。每格另有一条预热,不计入正式耗时。下面统一摘录实际 8 步的全部六组,原矩阵的 50 步请求不参与这里的倍数计算。
| 模式/目标 | 步数(关→开) | 耗时(关→开) | 8 卡 Wh(关→开) | 倍数 |
|---|---|---|---|---|
| T2VA / 15 秒 | 8 → 8 | 174.34 → 116.24 s | 109.62 → 75.97 | 1.50× |
| FL2VA / 15 秒 | 8 → 8 | 185.38 → 122.26 s | 116.35 → 80.02 | 1.52× |
| Ref2VA / 15 秒 | 8 → 8 | 233.54 → 152.38 s | 148.56 → 99.11 | 1.53× |
| T2VA / 5 秒 | 8 → 8 | 33.07 → 27.06 s | 21.18 → 17.35 | 1.22× |
| FL2VA / 5 秒 | 8 → 8 | 39.09 → 29.08 s | 24.88 → 19.37 | 1.34× |
| Ref2VA / 5 秒 | 8 → 8 | 62.20 → 45.17 s | 40.22 → 29.71 | 1.38× |
表中耗时为提交至观察到 API 完成;比值由全精度原值计算。60/60 正式视频完成并通过文件有效性检查,60 条预热另列,失败/unknown/自动重试均为 0。来源为客户 CSV的“本轮同一步数”记录;旧试验和逐卡行不重复计入。
30 组配对全部提速 1.19–1.54×,单片八卡电量降低 14.61%–33.35%。但我们同时如实发布了保留意见:
- 画质不能一概判无损:15 秒低步数样片叠影明显,10/12 步更干净但更慢更耗电;T2VA 开启后构图和机位发生改变;
- 倍数的口径:只采用"相同实际步数"的开/关对比——早期"49 步 → 4 步"的比值是不同工作量的比较,已从结论中撤下;
- 每格 n=1,未测稳定分位数与多素材泛化;内容级音画同步未完整听审,不验收。
加速配方可以用,但要当成"候选配置"经过自己的配对验收,不能当成"官方承诺的收益"。
5.2 成片截图:速度之外,还发生了什么
以下三图直接引用项目保留的真实视频抽帧,沿用原始标签。每列分别为实际 4、6、8、10、12 步;上排 OFF,下排 ON;同一列对齐视频时间点。它们对应本轮配对试验,不能拿来代表前面 50 步矩阵的画质。
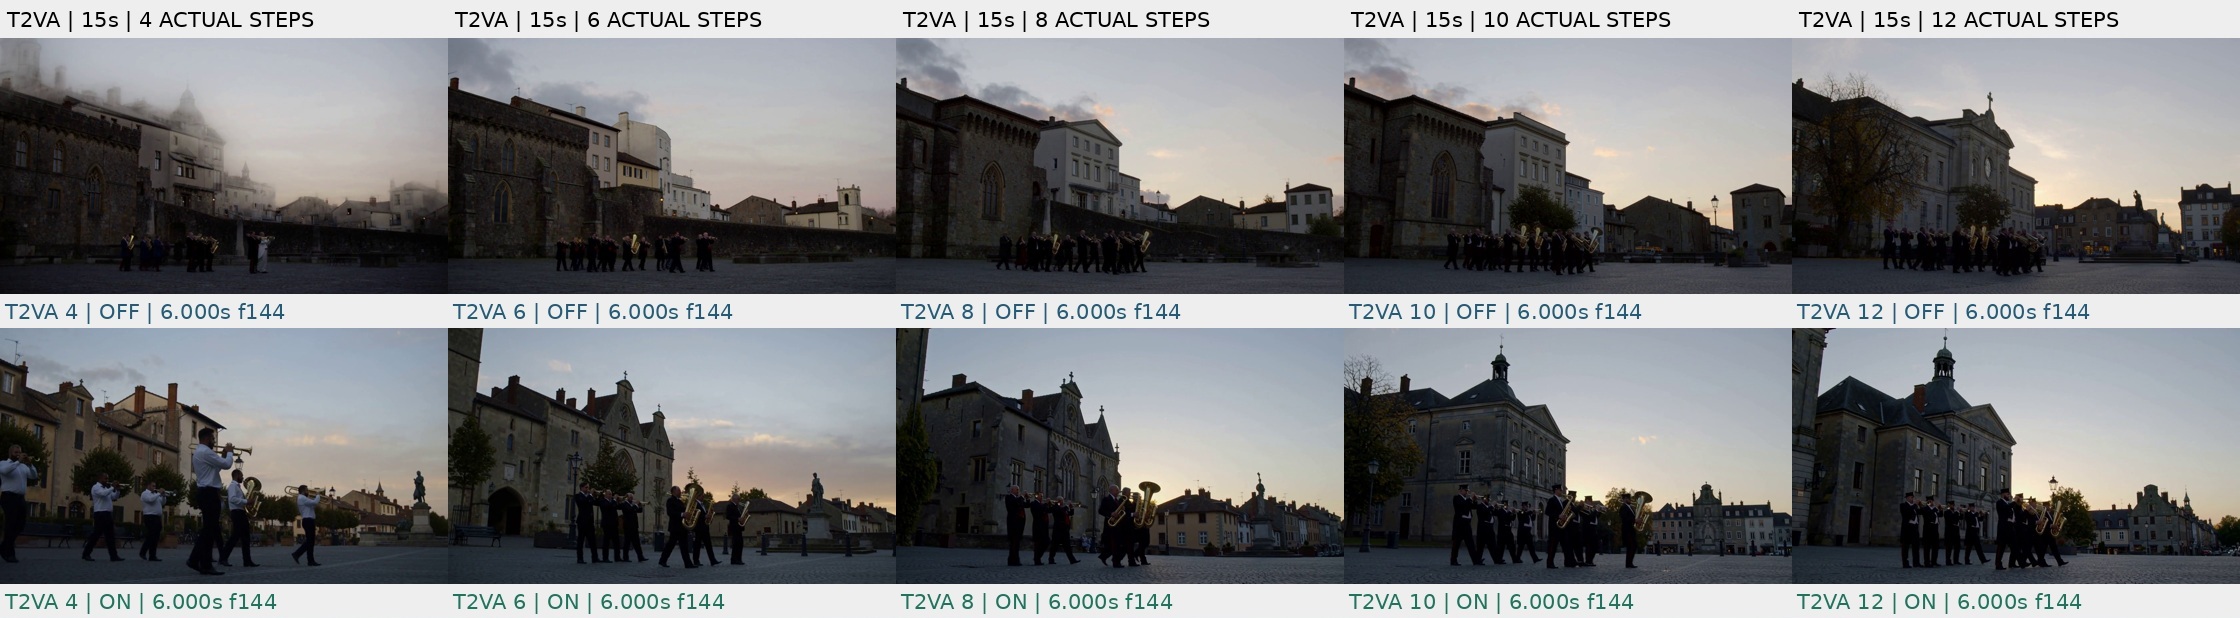
图 3|T2VA,目标 15 秒,抽取 6.000 秒 / f144。开启后乐队的景别、构图与机位发生变化。相同输入和种子提供比较条件,并不保证两套配方产生相同画面。
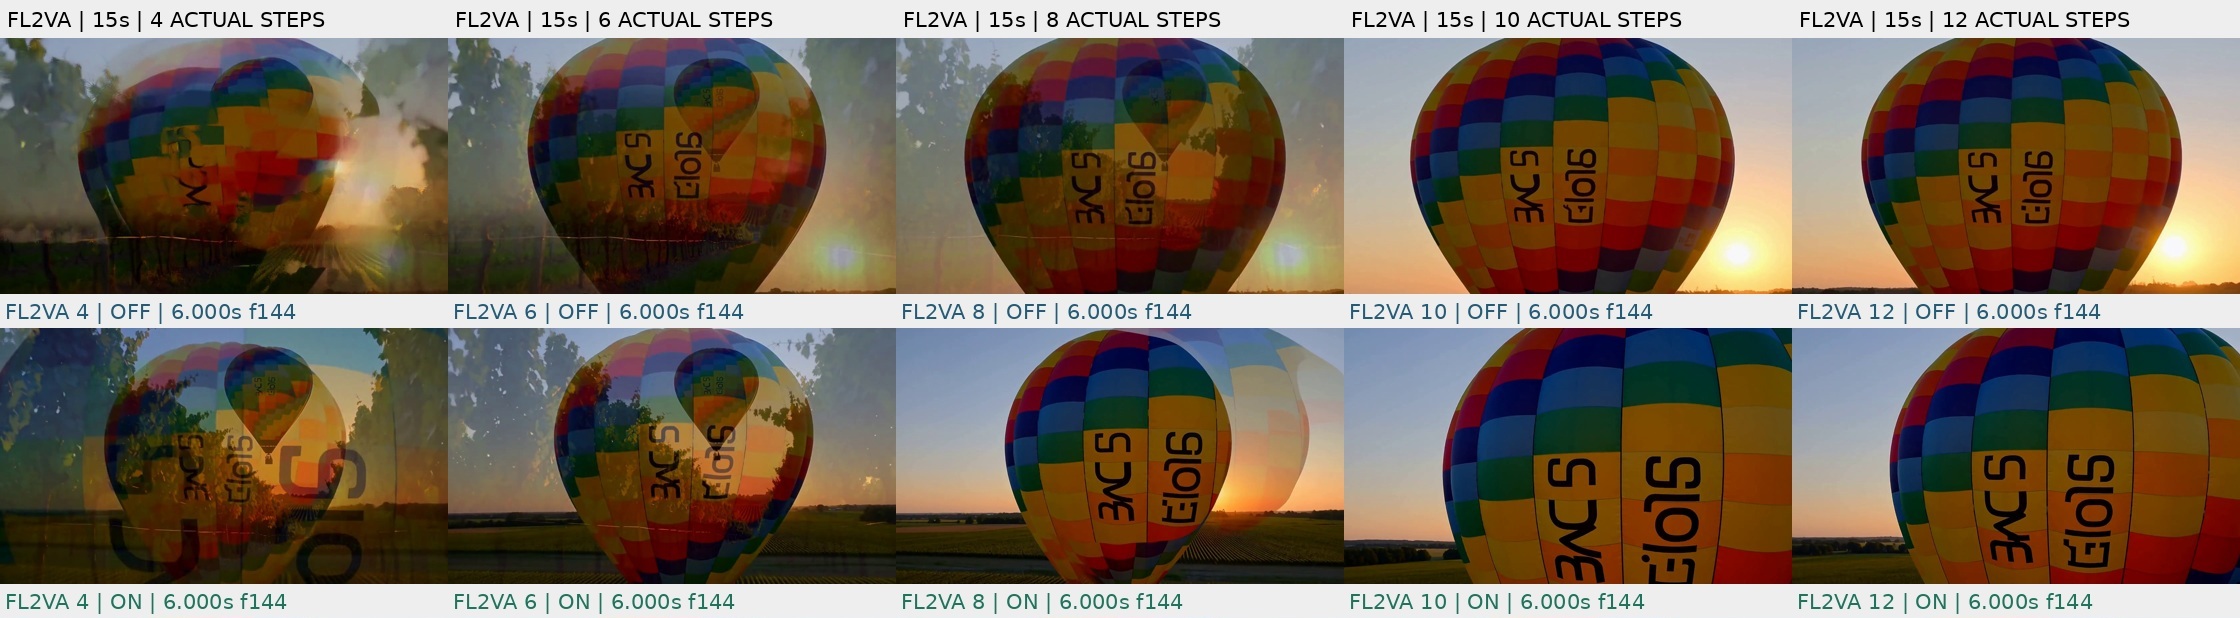
图 4|FL2VA,目标 15 秒,抽取 6.000 秒 / f144。低步数能看到树木、气球与前后场景的叠影;10/12 步在所查帧更干净,但整段仍有突切。单张清晰截图不能替代对转场过程的检查。
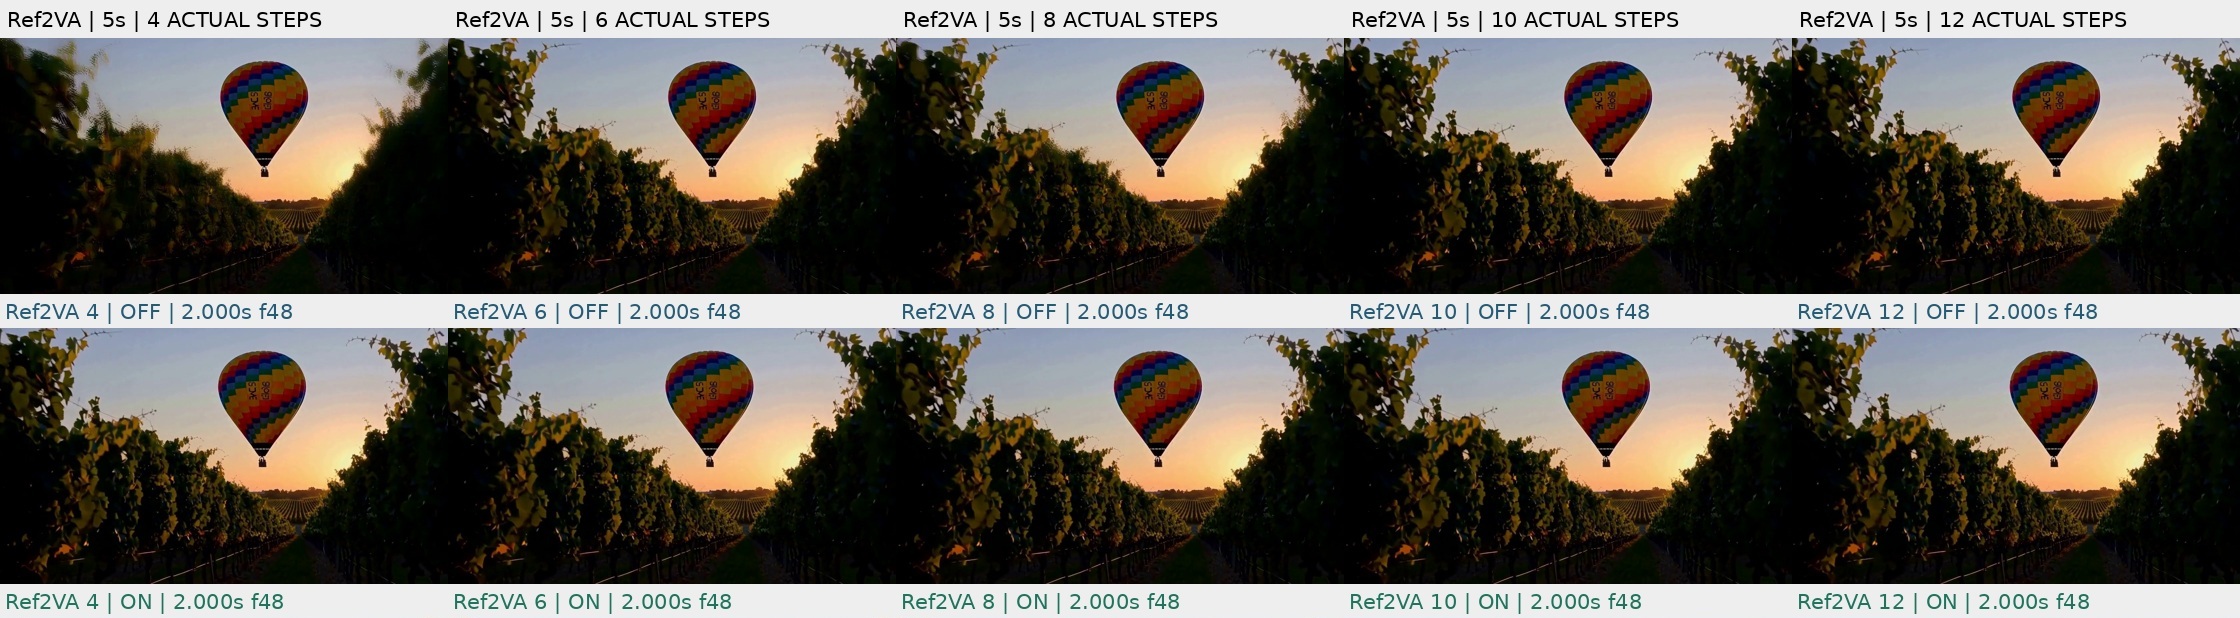
图 5|Ref2VA,目标 5 秒,抽取 2.000 秒 / f48。所查帧的气球主体总体接近,叶片清晰度和运动细节仍有差异。这是一个素材、每格 n=1 的观察,不能推导普遍无损。
三组原图与逐档观察见配对报告。这些样片完成了全片解码与时间轴筛查;内容级音画同步仍需完整听审。面向交付,验收应依次经过“任务 completed → 原片完整可读 → 人物/动作/接缝/声音审查”,截图主要帮助读者理解最后一关为何必要。
6. 难点三:从单用户到 100 用户,硬门槛在哪
该历史方案已通过受控单用户功能样例,但距离多人生产有两道硬门槛(通过前不开放入口):
门槛一:GPU 排队。 HTTP 连接限制 ≠ GPU 任务槽位:视频 POST 几秒内返回,GPU 还要跑几分钟——least_conn 选不出空闲 GPU。服务侧必须实现:
- 排队记录持久化(含用户配额与公平性);
- 槽位到任务明确终态才释放;
- 受理不明进入核查,禁止自动重投;
- worker 排空后再升级。
这层未过,只交付受控单任务试用。
门槛二:文件持久化与按用户授权。 任务元数据、产物归属、文件位置与摘要持久保存;下载、Range/HEAD 都验证当前身份;随机 UUID 不是授权机制——猜中别人的 id 也应被拒绝。
资源预算的起步锚点(配额加总,不是实测峰值):
| 项目 | 起步值 |
|---|---|
| 一个 CPU 工作区 | 2 vCPU / 4 GiB |
| 同时在线工作区 | 先限 10 个 |
| 单用户任务 | 1 条运行 + 最多 2 条等待 |
| 全池等待上限 | 健康实例数的 2 倍,满队明确返回 429 |
若 FL 有 10 个健康实例、每实例 C1,最多同时生成 10 片——100 人同时提交 ≠ 100 并发生成。
7. 效果与总结
| 交付 | 状态 | 边界 |
|---|---|---|
| 单机 8 卡 TP2/U4 算力单元 | 原五布局、18 类对照中平均耗时最短 | 短测结果,未证明生产 SLO |
| 公网单入口 + 双段鉴权链路 | 公网浏览器全链路样例通过(提交/查询/预览/下载,三端 SHA 一致) | HTTP 未加密;HTTPS 与多用户隔离未验收 |
| 双片并行 | 已验证 | 25 路产能与自动调度未验收 |
| 加速配方 | 30 组配对 1.19–1.54×、省电 14.6%–33.4% | 每格 n=1;画质保留意见 |
四条经验:
- 视频服务化先把任务生命周期做正确,再谈吞吐——id 归属、终态释放、unknown 核查是正确性问题,不是体验问题;
- 布局由硬约束和矩阵共同决定:头数整除先筛一遍,剩下的用数据说话;
- GPU 节点保持纯粹,编排层放 CPU——两类故障域不要搅在一起;
- 对社区配方保持"配对验收"习惯:相同步数、相同输入、相同种子的开/关对照,n 小就写小,画质另验。
下一篇起进入硬件故障排查三部曲(单卡 Xid 79 证据链、8 卡对调定位、NVSwitch 物理链路):掉卡排查实录:RTX 5070 反复 Xid 79,如何用 1.48 GB 日志建立证据链。
系列目录
- KV Cache 与前缀缓存:从原理到 99.9% 命中率的生产实践
- PD 分离实战:Prefill/Decode 拆池、配比拐点与容量规划
- GPU→内存→SSD 三级 KV 缓存:Mooncake 分层实战与跨引擎复用陷阱
- Kimi-K3 原始 MXFP4 权重512K 长上下文生产部署:双机 16 卡 TP8×PP2 与 CUDA Graph 调优
- 大模型压测方法论:如何让性能数据可信
- 推理集群可观测性:64 卡监控体系与缓存证据链
- MiniMax-H3视频生成服务化:ComfyUI 多 GPU 编排与长任务生命周期(本篇)
- 掉卡排查实录:RTX 5070 反复 Xid 79,如何排查建立证据链
- GPU对调定位法:8 卡 RTX 6000D 掉卡,如何用对调缩小故障范围
- CUDA 802 不是 NCCL 网络故障:H20 NVSwitch 物理链路排查实录
- DeepSeek-V4.1-Flash 双机 16 卡 H20 部署压测:TP8×DP2 与跨机 EP 的边界
数据声明:本文数据来自受控内部测试环境;矩阵点与配对关系均已注明样本量。